7.1 湖仓一体概述
湖仓一体之前,数据分析经历了数据库、数据仓库和数据湖分析三个时代。
-
首先是数据库,它是一个最基础的概念,主要负责联机事务处理,也提供基本的数据分析能力。
-
随着数据量的增长,出现了数据仓库,它存储的是经过清洗、加工以及建模后的高价值的数据,供业务人员进行数据分析。
-
数据湖的出现,主要是为了去满足企业对原始数据的存储、管理和再加工的需求。这里的需求主要包括两部分,首先要有一个低成本的存储,用于存储结构化、半结构化,甚至非结构化的数据;另外,就是希望有一套包括数据处理、数据管理以及数据治理在内的一体化解决方案。
数据仓库解决了数据快速分析的需求,数据湖解决了数据的存储和管理的需求,而湖仓一体要解决的就是如何让数据能够在数据湖和数据仓库之间进行无缝的集成和自由的流转,从而帮助用户直接利用数据仓库的能力来解决数据湖中的数据分析问题,同时又能充分利用数据湖的数据管理能力来提升数据的价值。
1 适用场景
Doris 在设计湖仓一体时,主要考虑如下四个应用场景:
-
湖仓查询加速:
Doris作为一个非常高效的OLAP查询引擎,有着非常好的MPP向量化的分布式的查询层,可以直接利用Doris非常高效的查询引擎,对湖上数据进行加速分析。 -
统一数据分析网关:提供各类异构数据源的查询和写入能力,支持用户将这些外部数据源统一到
Doris的元数据映射结构上,当用户通过Doris查询这些外部数据源时,能够提供一致的查询体验。 -
统一数据集成:首先通过数据湖的数据源连接能力,能够让多数据源的数据以增量或全量的方式同步到
Doris,并且利用Doris的数据处理能力对这些数据进行加工。加工完的数据一方面可以直接通过Doris对外提供查询,另一方面也可以通过Doris的数据导出能力,继续为下游提供全量或增量数据服务。通过Doris可以减少对外部工具的依赖,可以直接将上下游数据,以及包括同步、加工、处理在内的整条链路打通。 -
更加开放的数据平台:众多数据仓库有着各自的存储格式,用户如果想要使用一个数据仓库,第一步就需要把外部数据通过某种方式导入到数据仓库中才能进行查询。这样就是一个比较封闭的生态,数据仓库中数据除了数仓自己本身可以查询以外,其它外部工具是无法进行直接访问的。一些企业在使用包括
Doris在内的一些数仓产品的时候就会有一些顾虑,比如数据是否会被锁定到某一个数据仓库里,是否还有便捷的方式进行导出。通过湖仓一体生态的接入,可以用更加开放的数据格式来管理数据,比如可以用Parquet/ORC格式来去存储数据,这样开放开源的数据格式可以被很多外部系统去访问。另外,Iceberg,Hudi等都提供了开放式的元数据管理能力,不管元数据是存储在Doris本身,还是存储在Hive Meta store,或者存储在其它统一元数据中心,都可以通过一些对外公开的API对这些数据进行管理。通过更加开放的数据生态,可以帮助企业更快地接入一个新的数据管理系统,降低企业数据迁移的成本和风险。
2 基于 Doris 的湖仓一体架构
Doris 通过多源数据目录( Multi-Catalog )功能,支持了包括 Apache Hive 、 Apache Iceberg 、 Apache Hudi 、 Apache Paimon 、 LakeSoul 、 Elasticsearch 、 MySQL 、 Oracle 、 SQL Server 等主流数据湖、数据库的连接访问。以及可以通过 Apache Ranger 等进行统一的权限管理,具体架构如下:
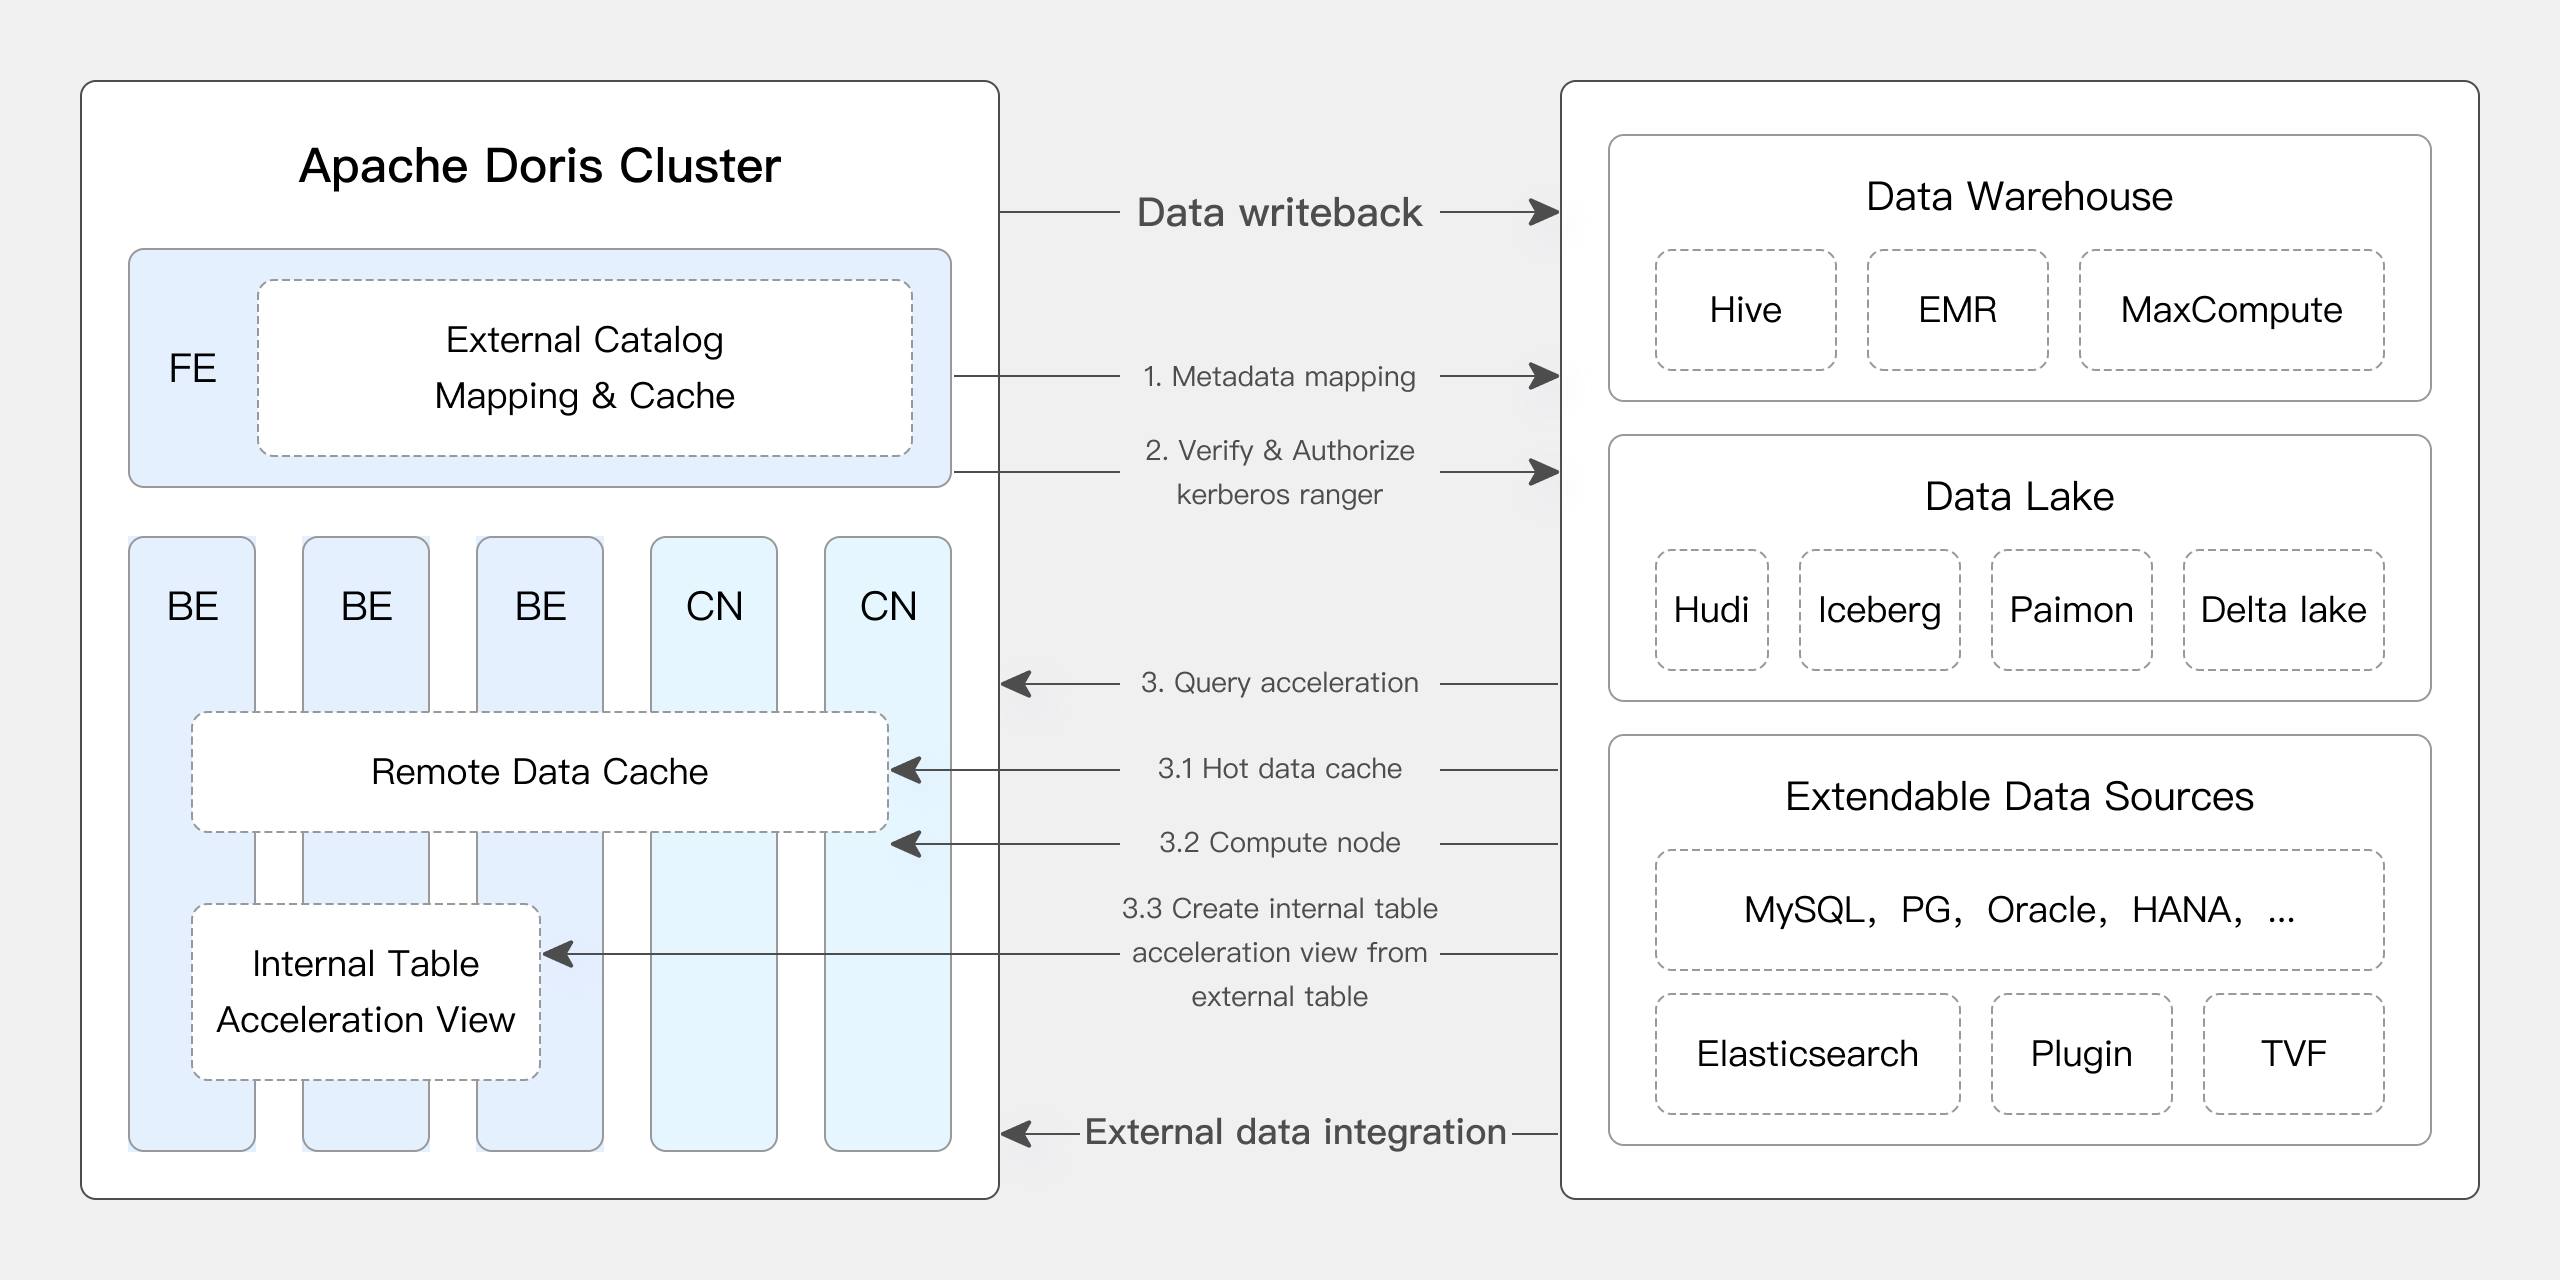
其数据湖的主要对接流程为:
-
创建元数据映射:
Doris通过Catalog获取数据湖元数据并缓存在Doris中,用于数据湖元数据的管理。在元数据映射过程中Doris除了支持传统JDBC的用户名密码认证外,还支持基于Kerberos和Ranger的权限认证,基于KMS的数据加密。 -
发起查询操作:当用户从
FE发起数据湖查询时,Doris使用自身存储的数据湖元数生成造查询计划,利用Native的Reader组件从外部存储(HDFS、S3)上获取数据进行数据计算和分析。在数据查询过程中Doris会将数据湖热点数据缓存在本地,当下次相同查询到来时数据缓存能很好起到查询加速的效果。 -
结果返回:当查询完成后将查询结果通过
FE返回给用户。 -
计算结果入湖:当用户并不想将计算结果返回,而是需要将计算结果进一步写入数据湖时可以通过
export的方式以标准数据格式(CSV、Parquet、ORC)将数据写回数据湖。
3 核心技术
在多源数据连接上 Doris 通过可扩展连接器读取外部数据。同时通过元数据缓存、数据缓存、 Native Reader 、 IO 优化、统计信息优化等一些措施,极大加速了数据湖分析能力。
3.1 可扩展的连接框架
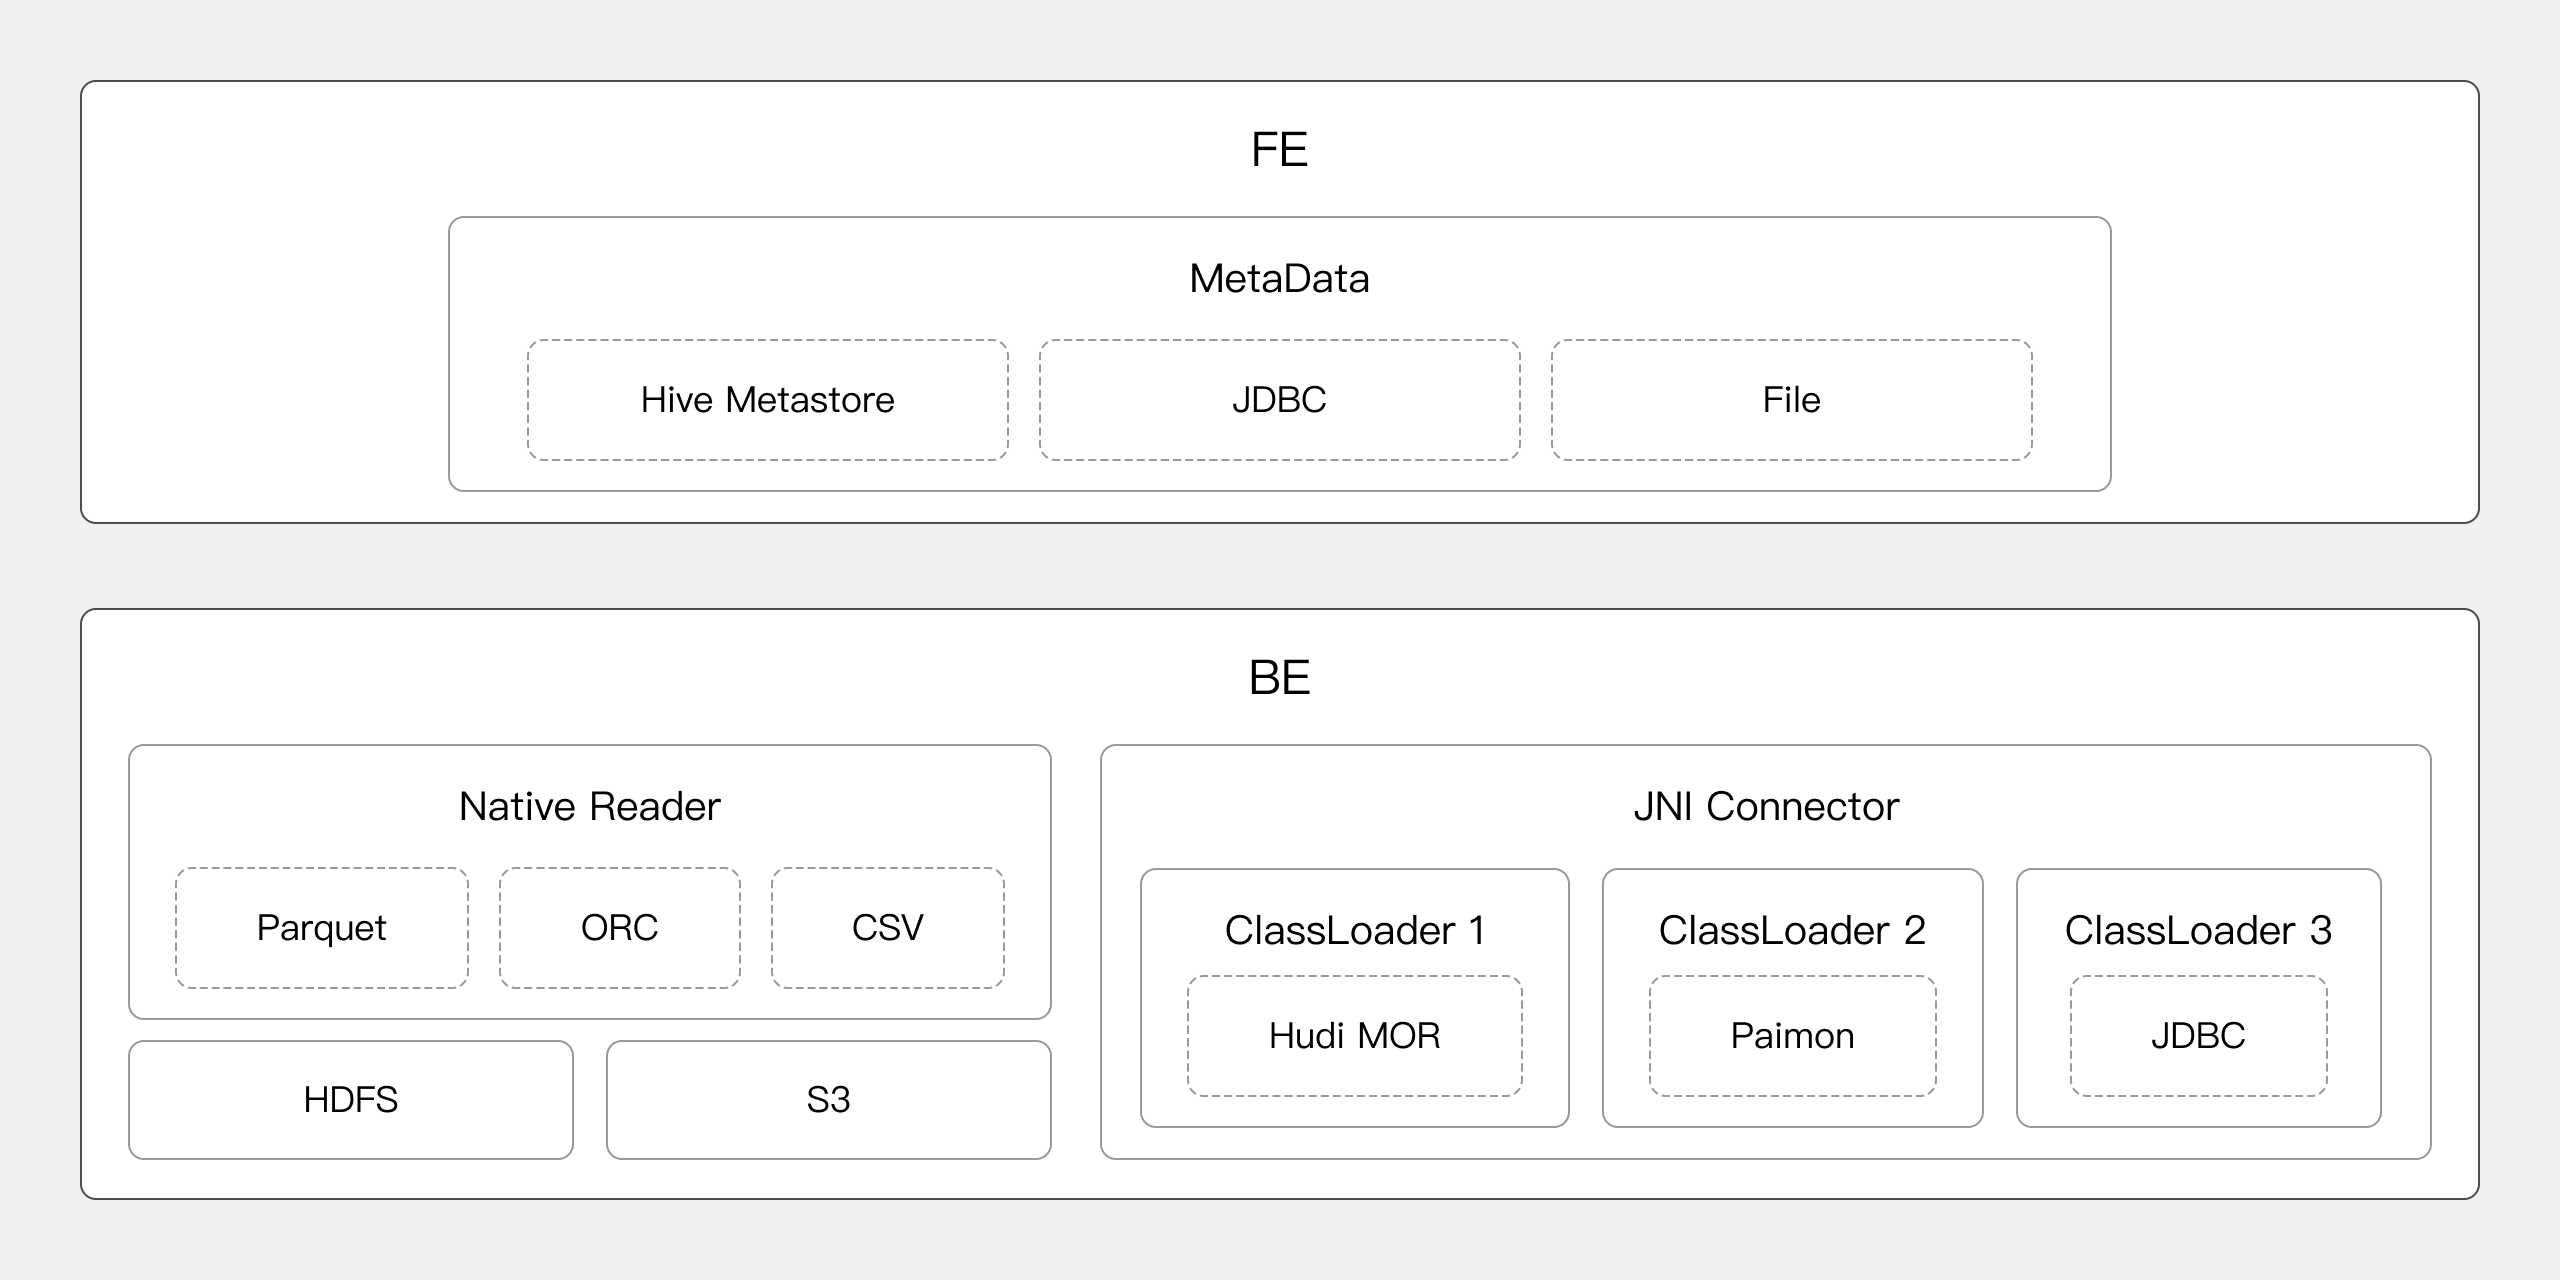
在数据的对接中包括元数据的对接和数据的读取。
-
元数据对接:元数据对接在
FE完成,通过FE的MetaData管理器来实现基于HiveMetastore、JDBC和文件的元数据对接和管理工作。 -
数据读取:通过
NativeReader可以高效的读取存放在HDFS、对象存储上的Parquet、ORC、Text格式数据。也可以通过JniConnector对接Java大数据生态。
3.2 高效缓存策略
Doris 通过元数据缓存、数据缓存和查询结果缓存来提升查询性能。
3.2.1 元数据缓存
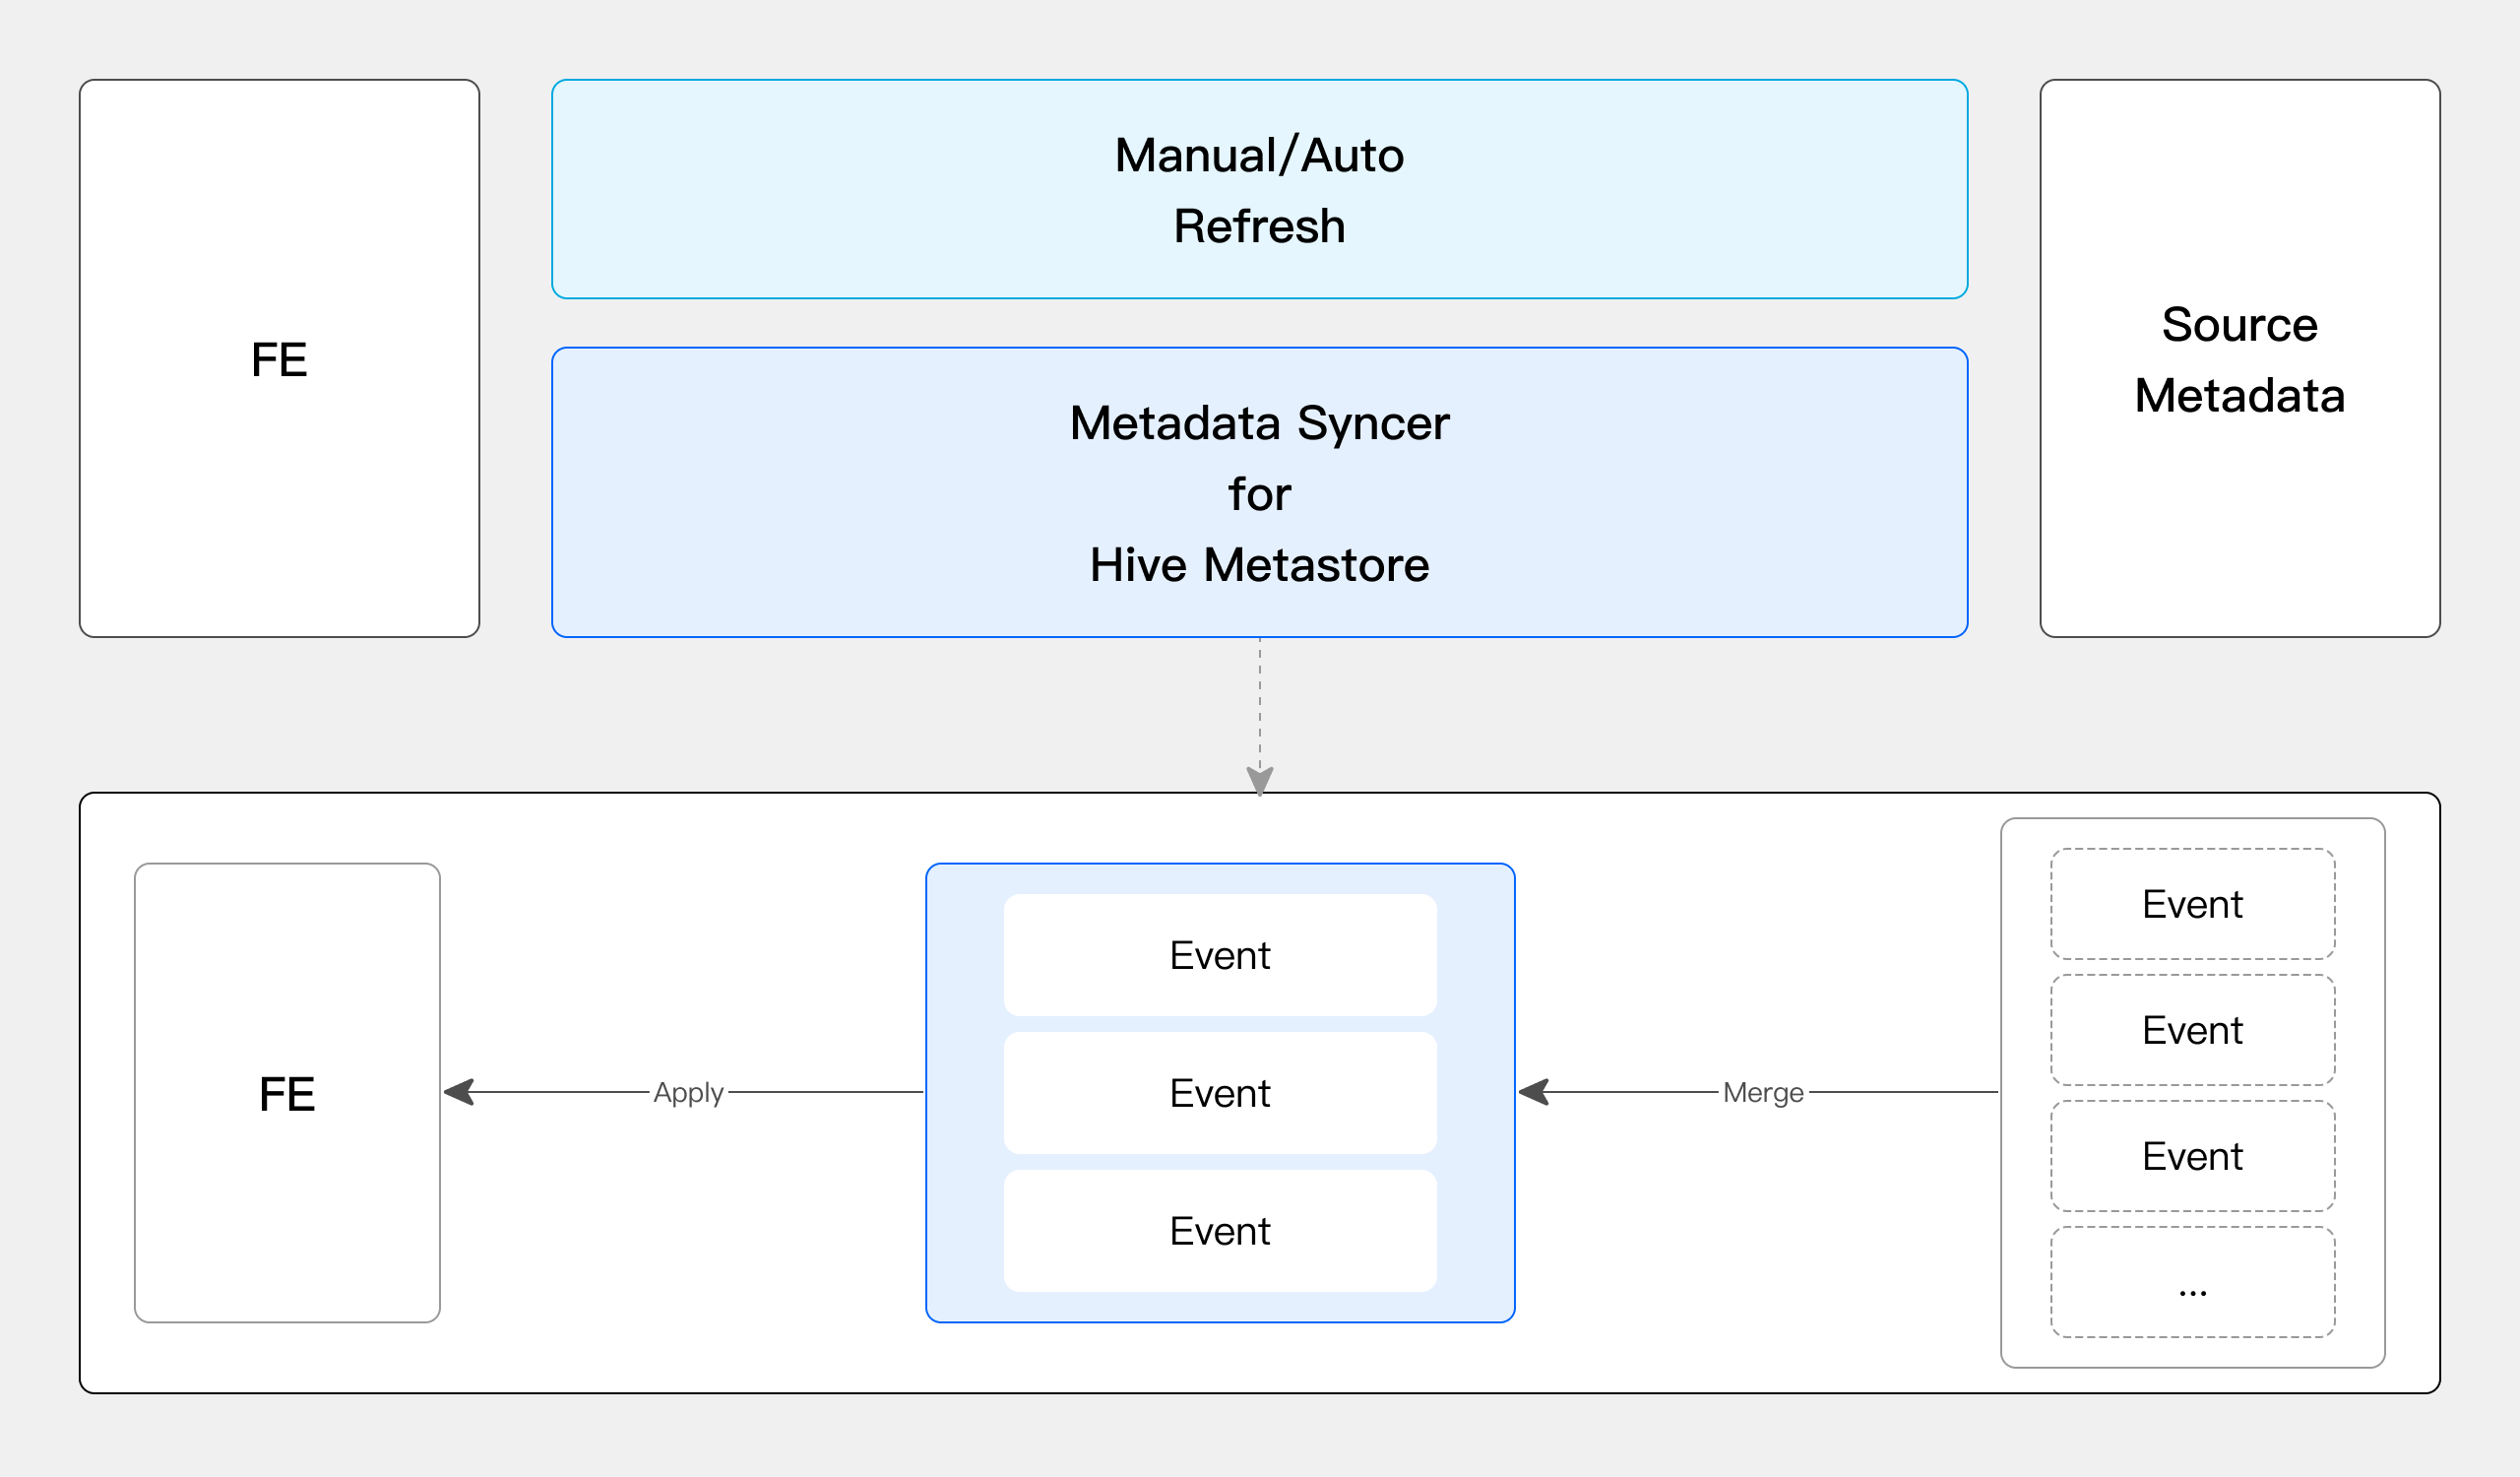
Doris 提供了手动同步元数据、定期自动同步元数据、元数据订阅(只支持 HiveMetastore )三种方式来同步数据湖的元数据信息到 Doris ,并将元数据存储在 Doris 的 FE 的内存中。当用户发起查询后 Doris 直接从内存中获取元数据并快速生成查询规划。保障了元数据的实时和高效。在元数据同步上 Doris 通过并发的元数据事件合并实现高效的元数据同步,其每秒可以处理 100 个以上的元数据事件。
3.2.2 高效的数据缓存
-
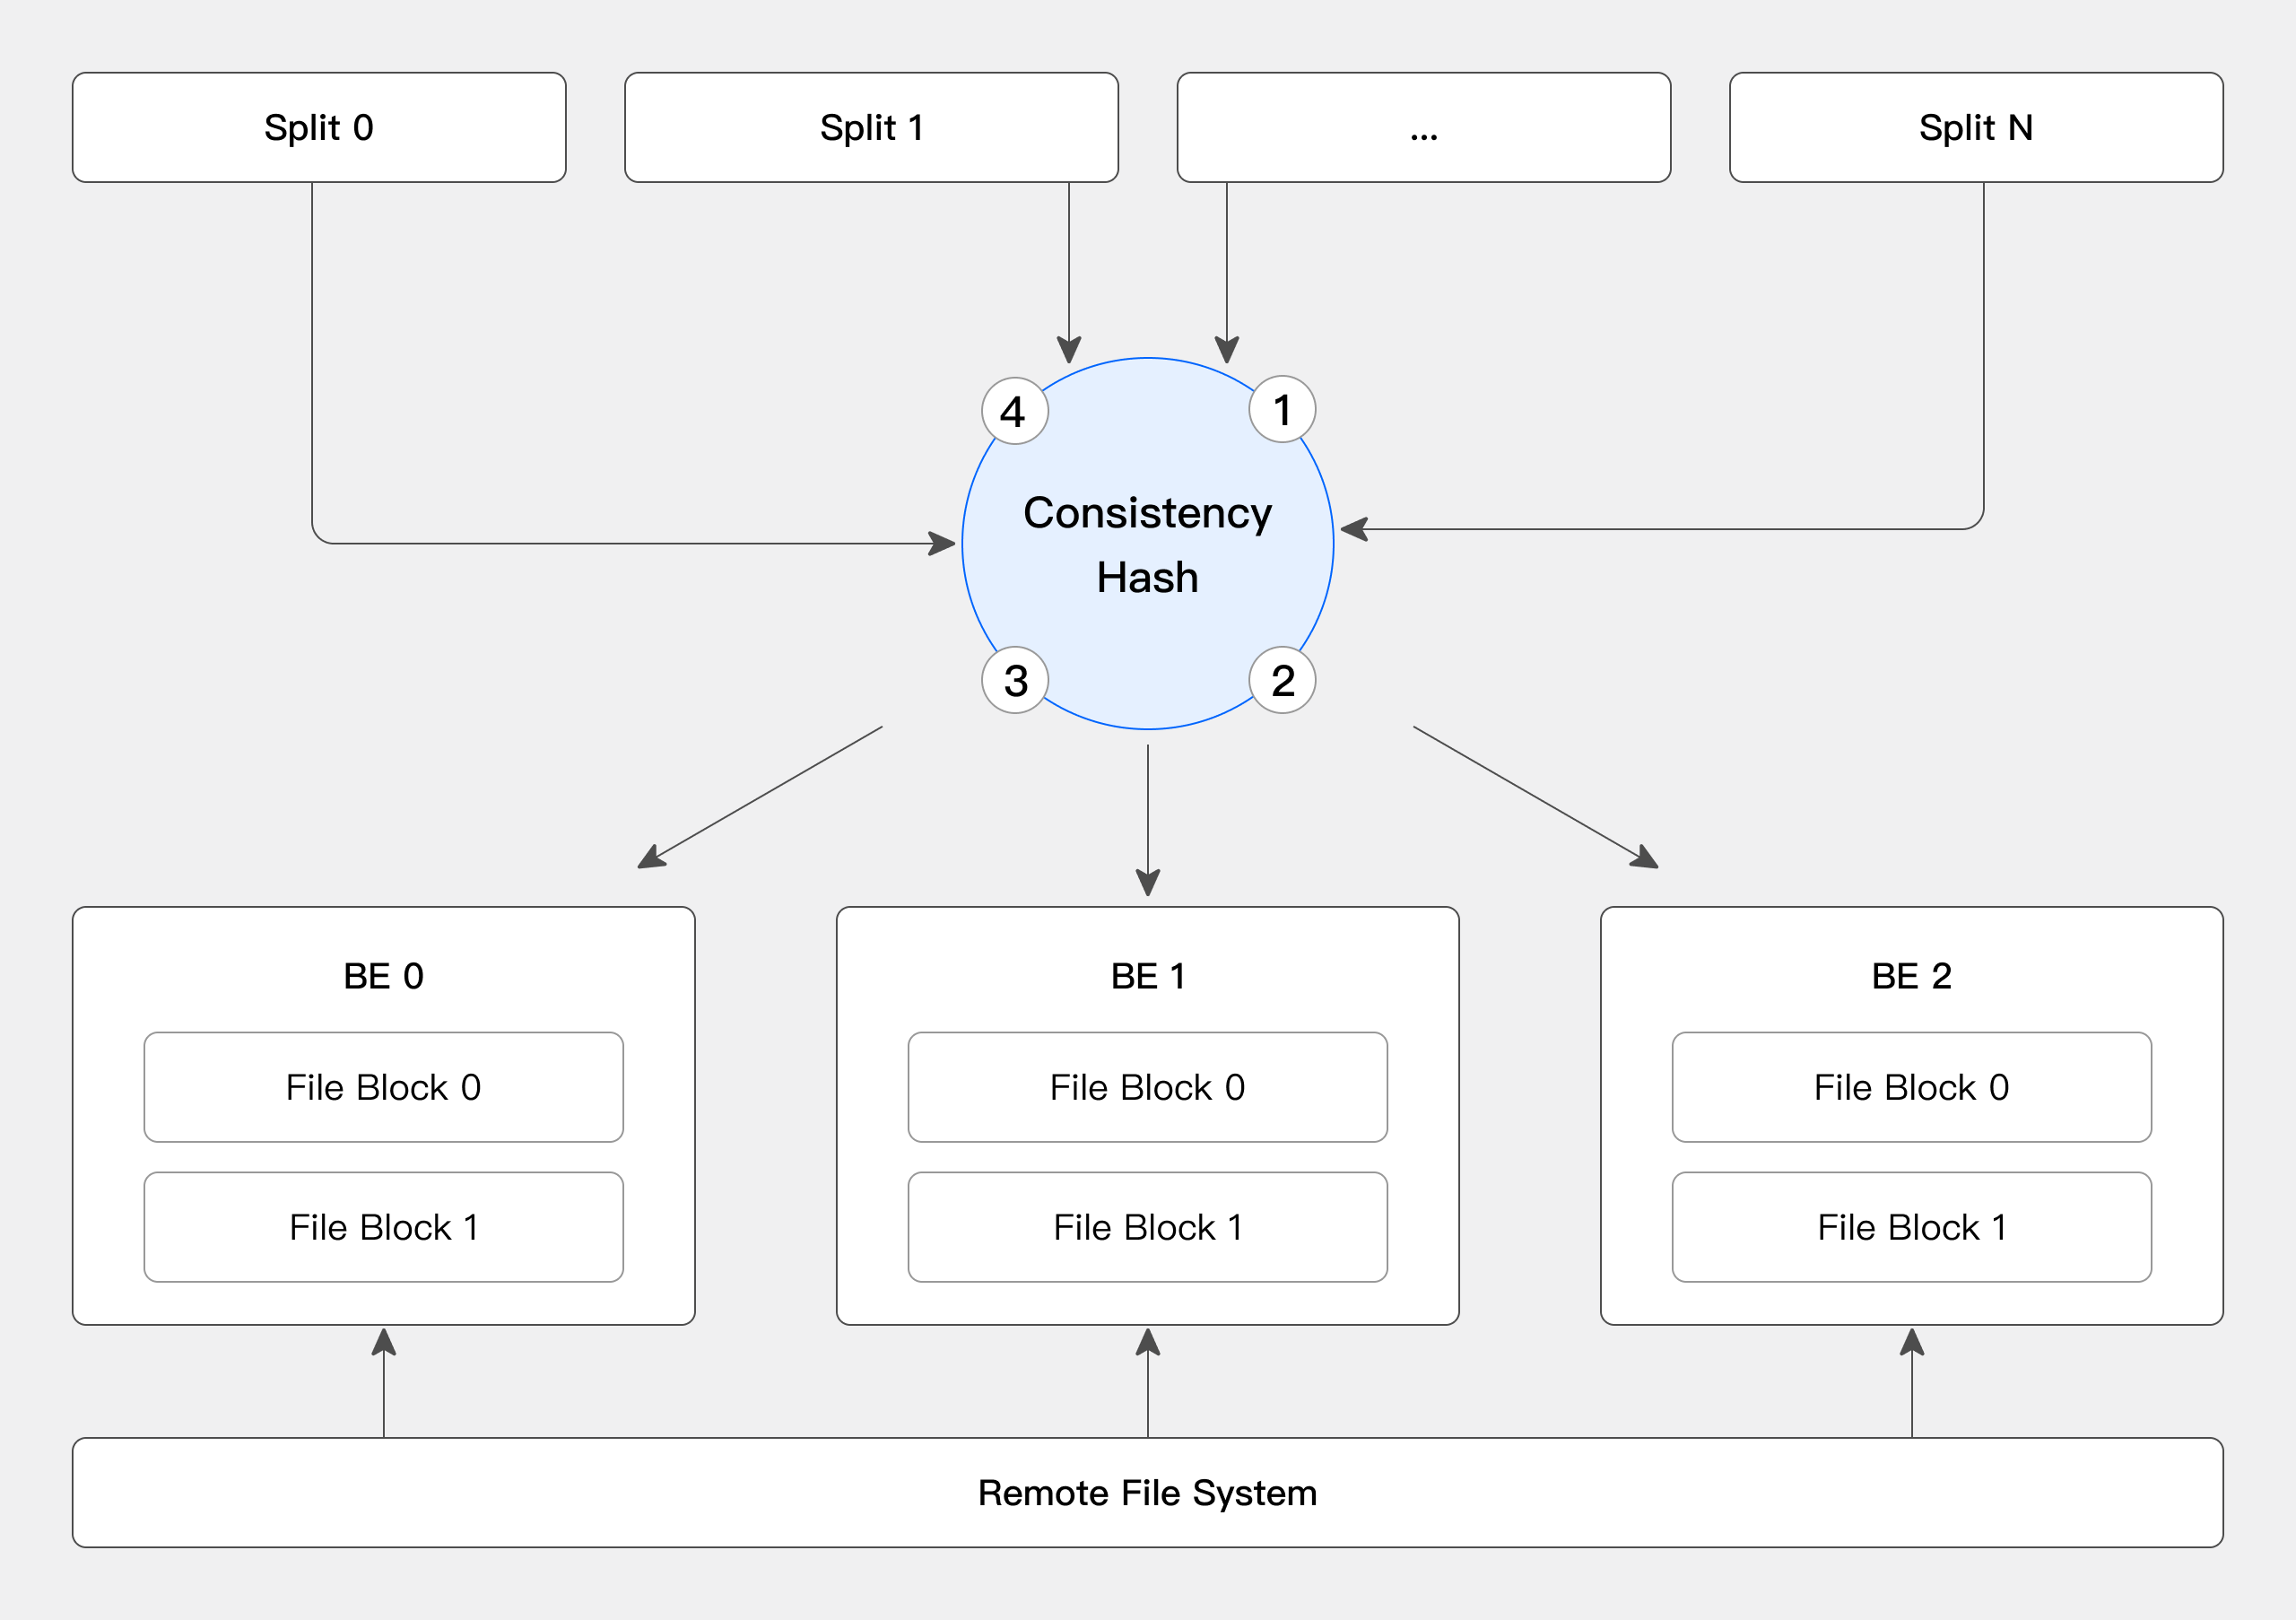
文件缓存:
Doris通过将数据湖中的热点数据存储在本地磁盘上,减少数据扫描过程中网络数据的传输,提高数据访问的性能。 -
缓存分布策略:在数据缓存中
Doris通过一致性哈希将数据分布在各个BE节点上,尽量避免节点扩缩容带来的缓存失效问题。 -
缓存淘汰(更新)策略:同时当
Doris发现数据文件对应的元数据更新后,会及时淘汰缓存以保障数据的一致性。
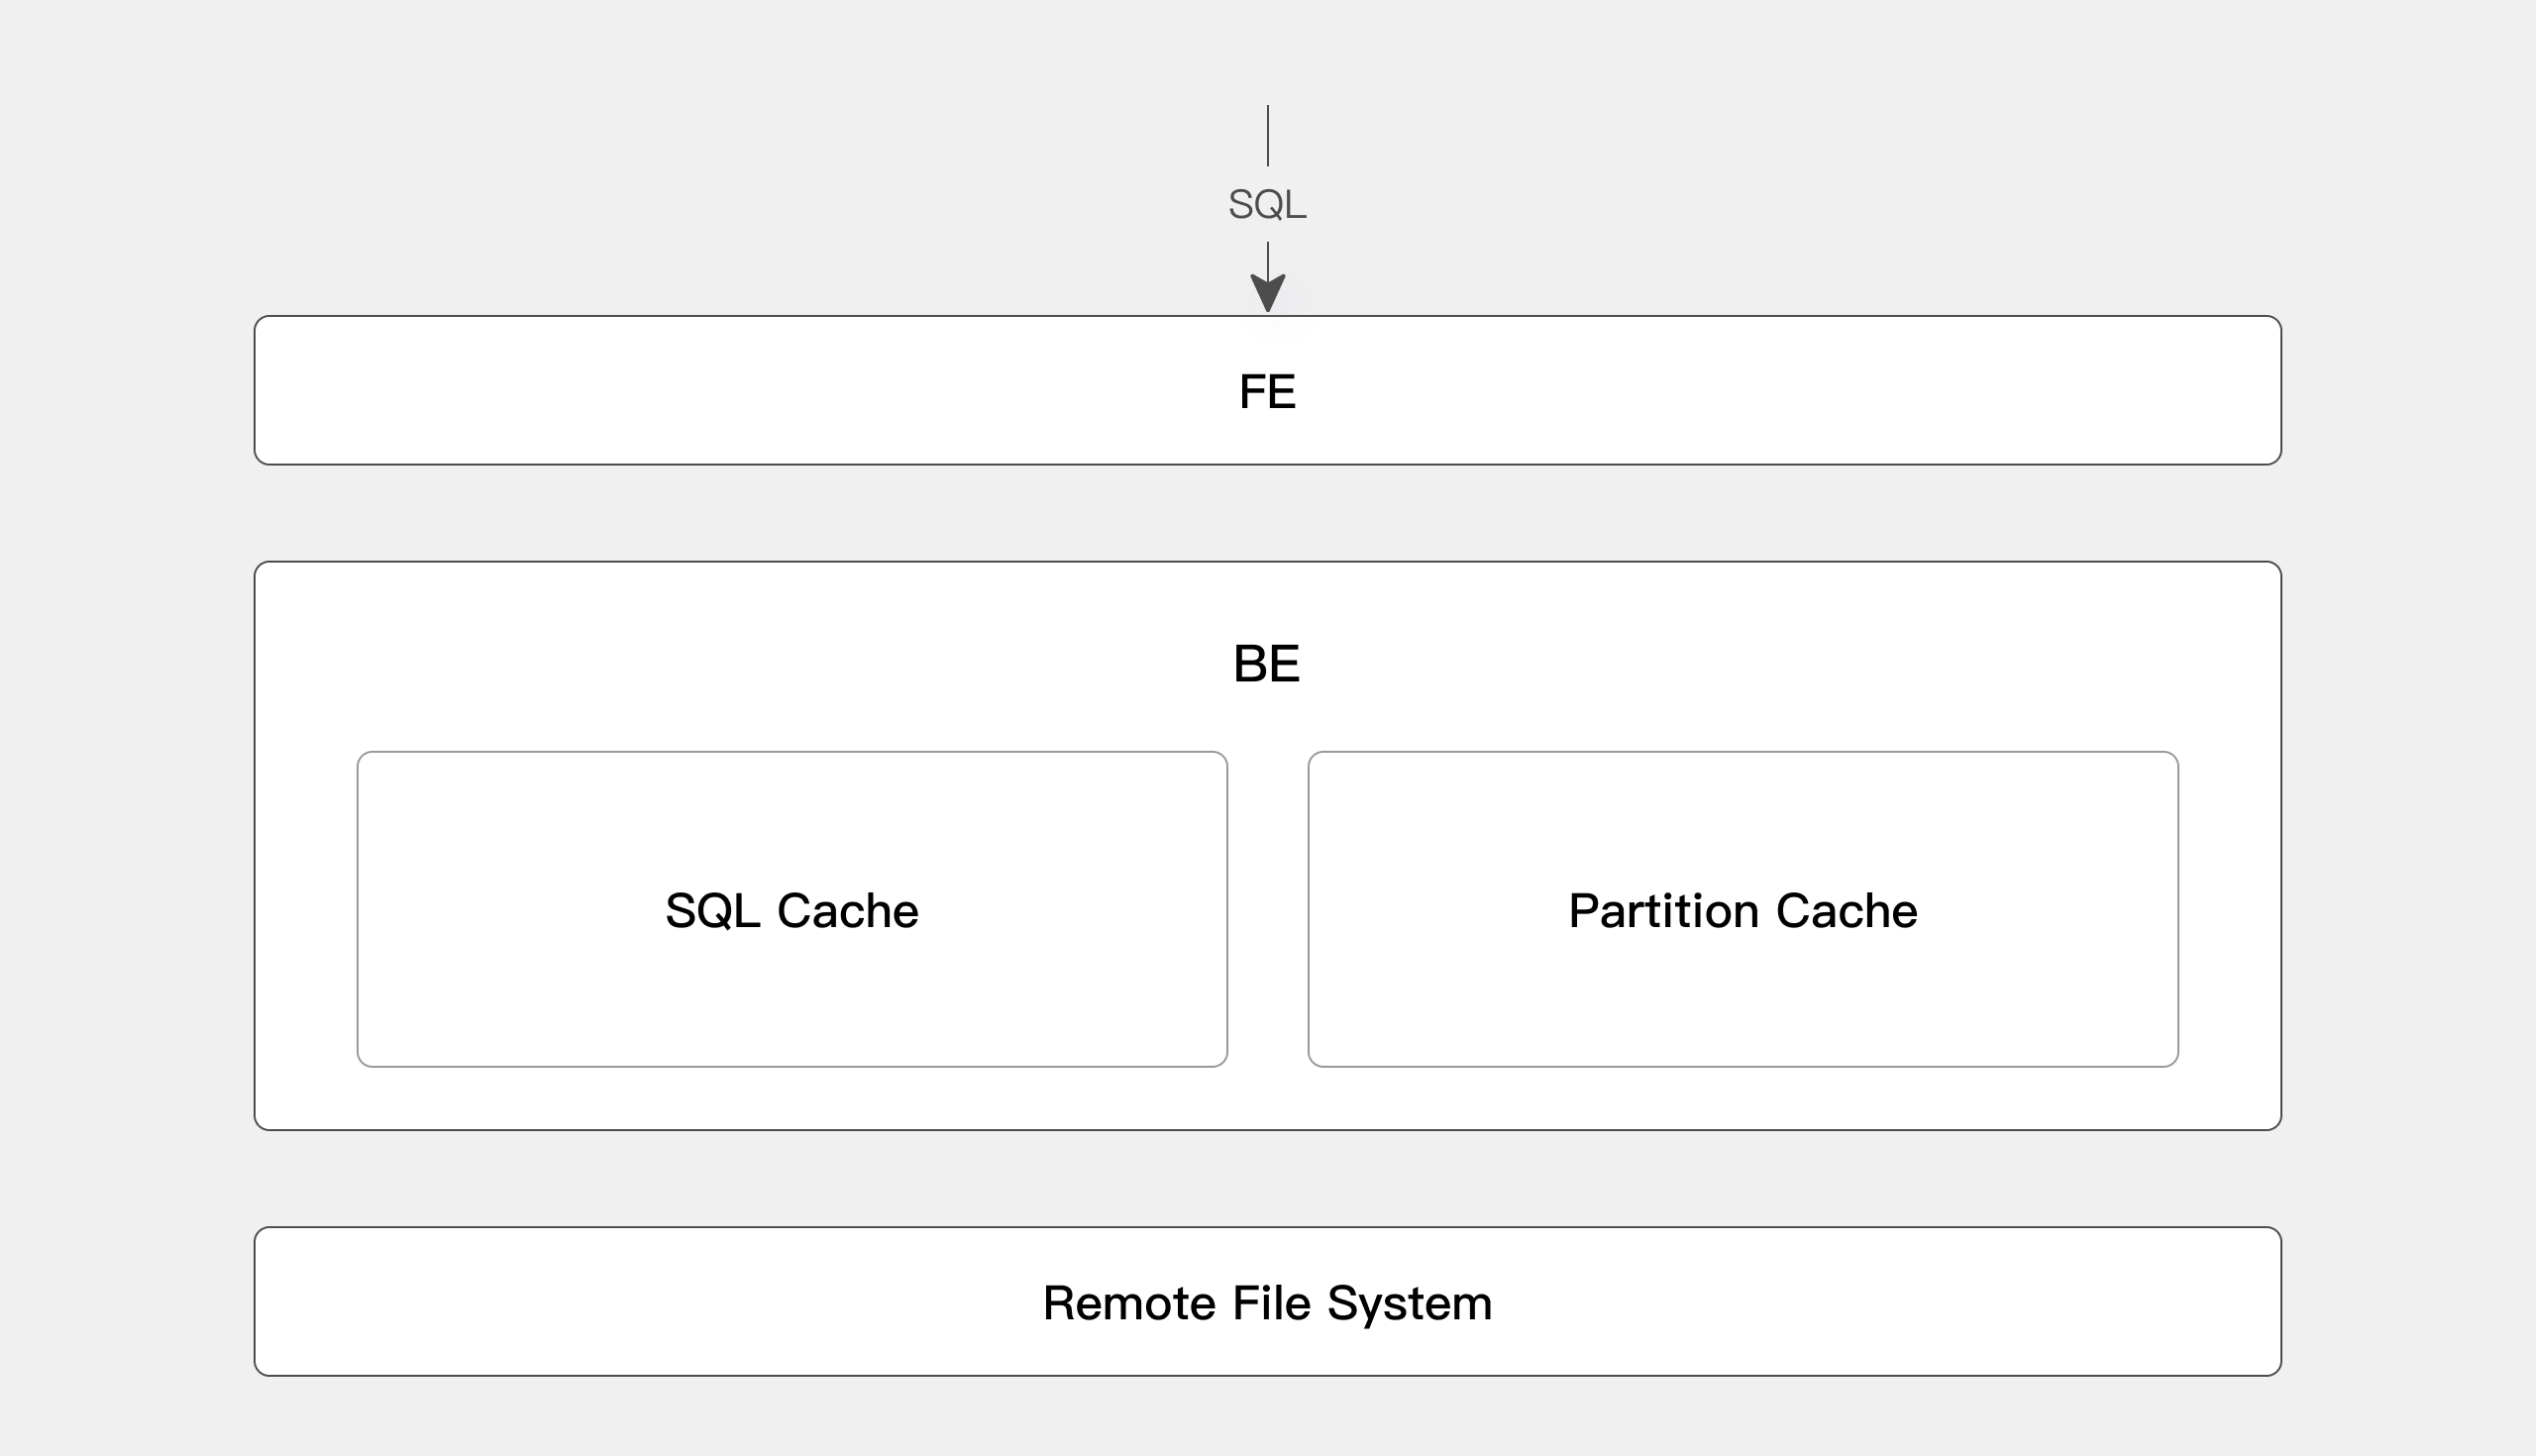
3.2.3 查询结果缓存和分区缓存
-
查询结果缓存:
Doris根据SQL语句将之前查询的结果缓存起来,当下次相同的查询再次发起时可以直接从缓存中获取数据返回到客户端,极大的提高了查询的效率和并发。 -
分区缓存:
Doris还支持将部分分区数据缓存在BE端提升查询效率。比如查询最近7天的数据,可以将前6天的计算后的缓存结果,和当天的事实计算结果进行合并,得到最终查询结果,最大限度减少实时计算的数据量,提升查询效率。
3.3 高效的 Native Reader
-
自研
Native Reader避免数据转换:Doris在数据分析时有其自身的列存方式,同时Parquet、ORC也有自身的列存格式。如果直接使用开源的Parquet或者ORC Reader的话就会存在一个Doris列存和Parquet/ORC列存的转换过程。这样的话就会多一次格式转换的开销,为了解决这个问题我们自研了一套Parquet/ORC NativeReader,直接读取Parquet、ORC文件来提高查询效率。 -
延迟物化:同时我们实现的
Native Reader还能很好的利用智能索引和过滤器提高数据读取效率。比如说在某些场景下我可能只针对ID列去做一个过滤。我们的优化做法是首先第一步我会把ID列单独读出来。然后在这一列上做完过滤以后,我会把这个过滤后的剩余下来的这个行号记录下来。拿这个行号再去读剩下两列,这样来进一步的减少数据扫描,加速文件的分析性能。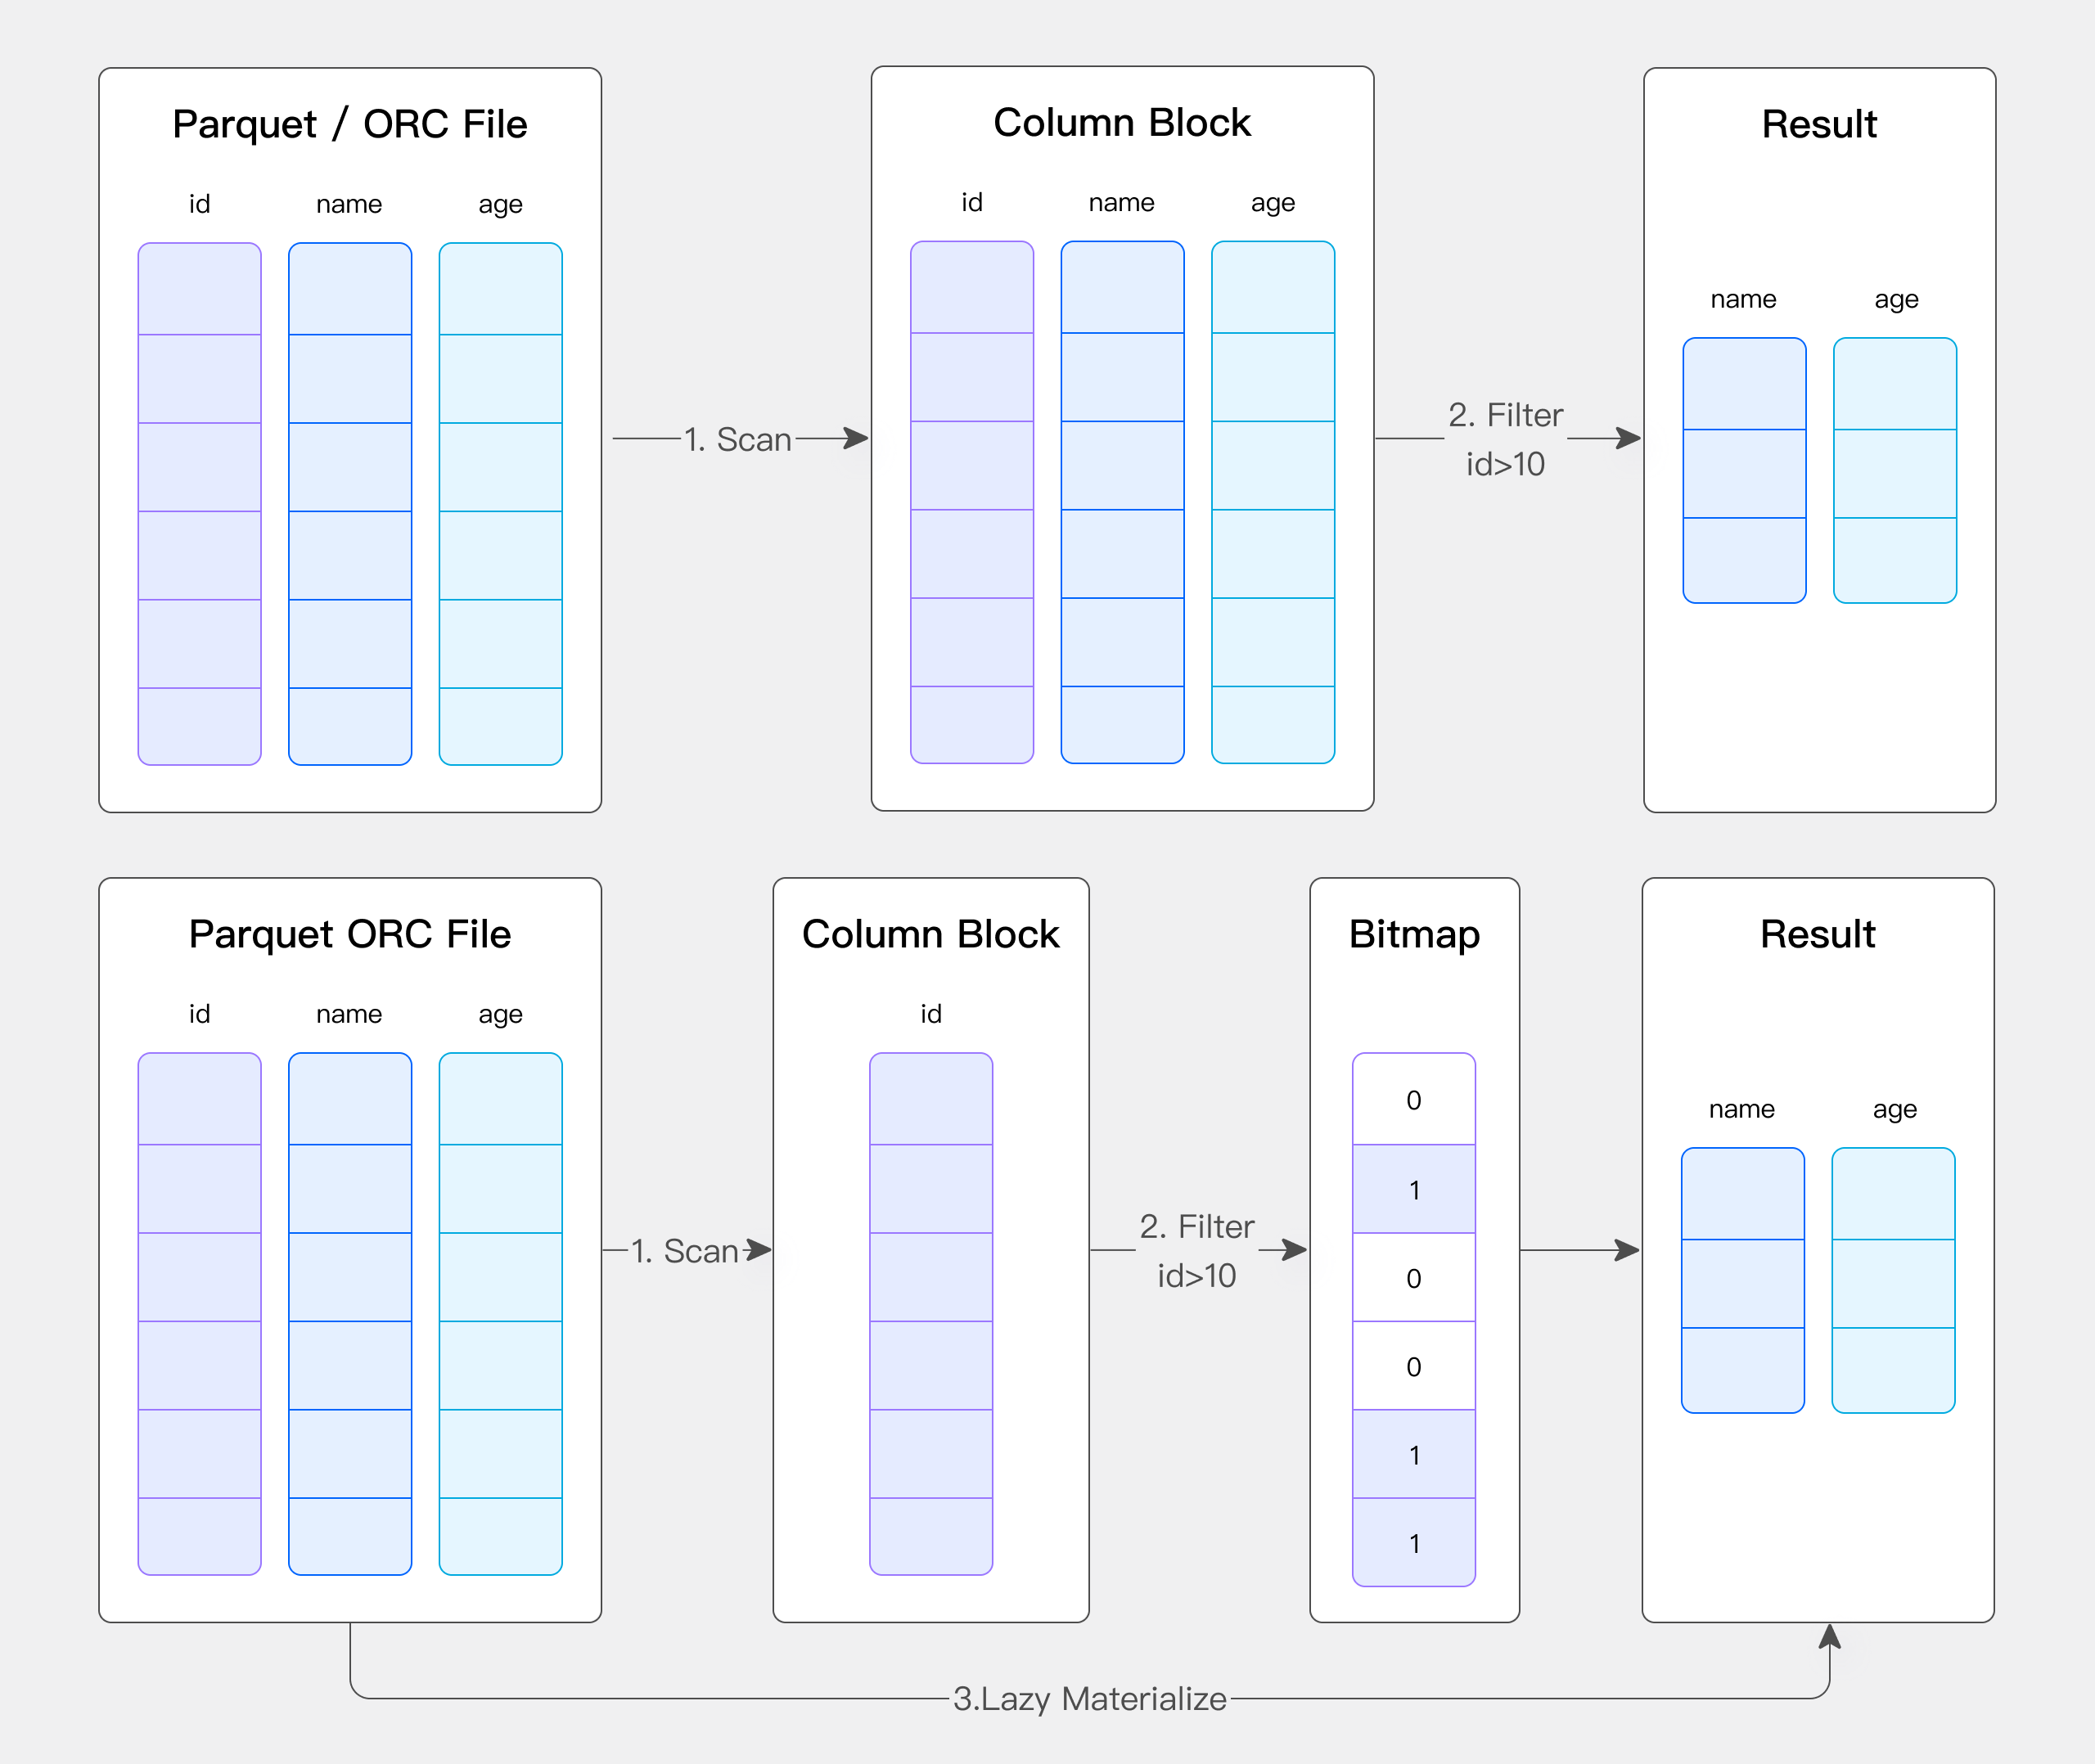
-
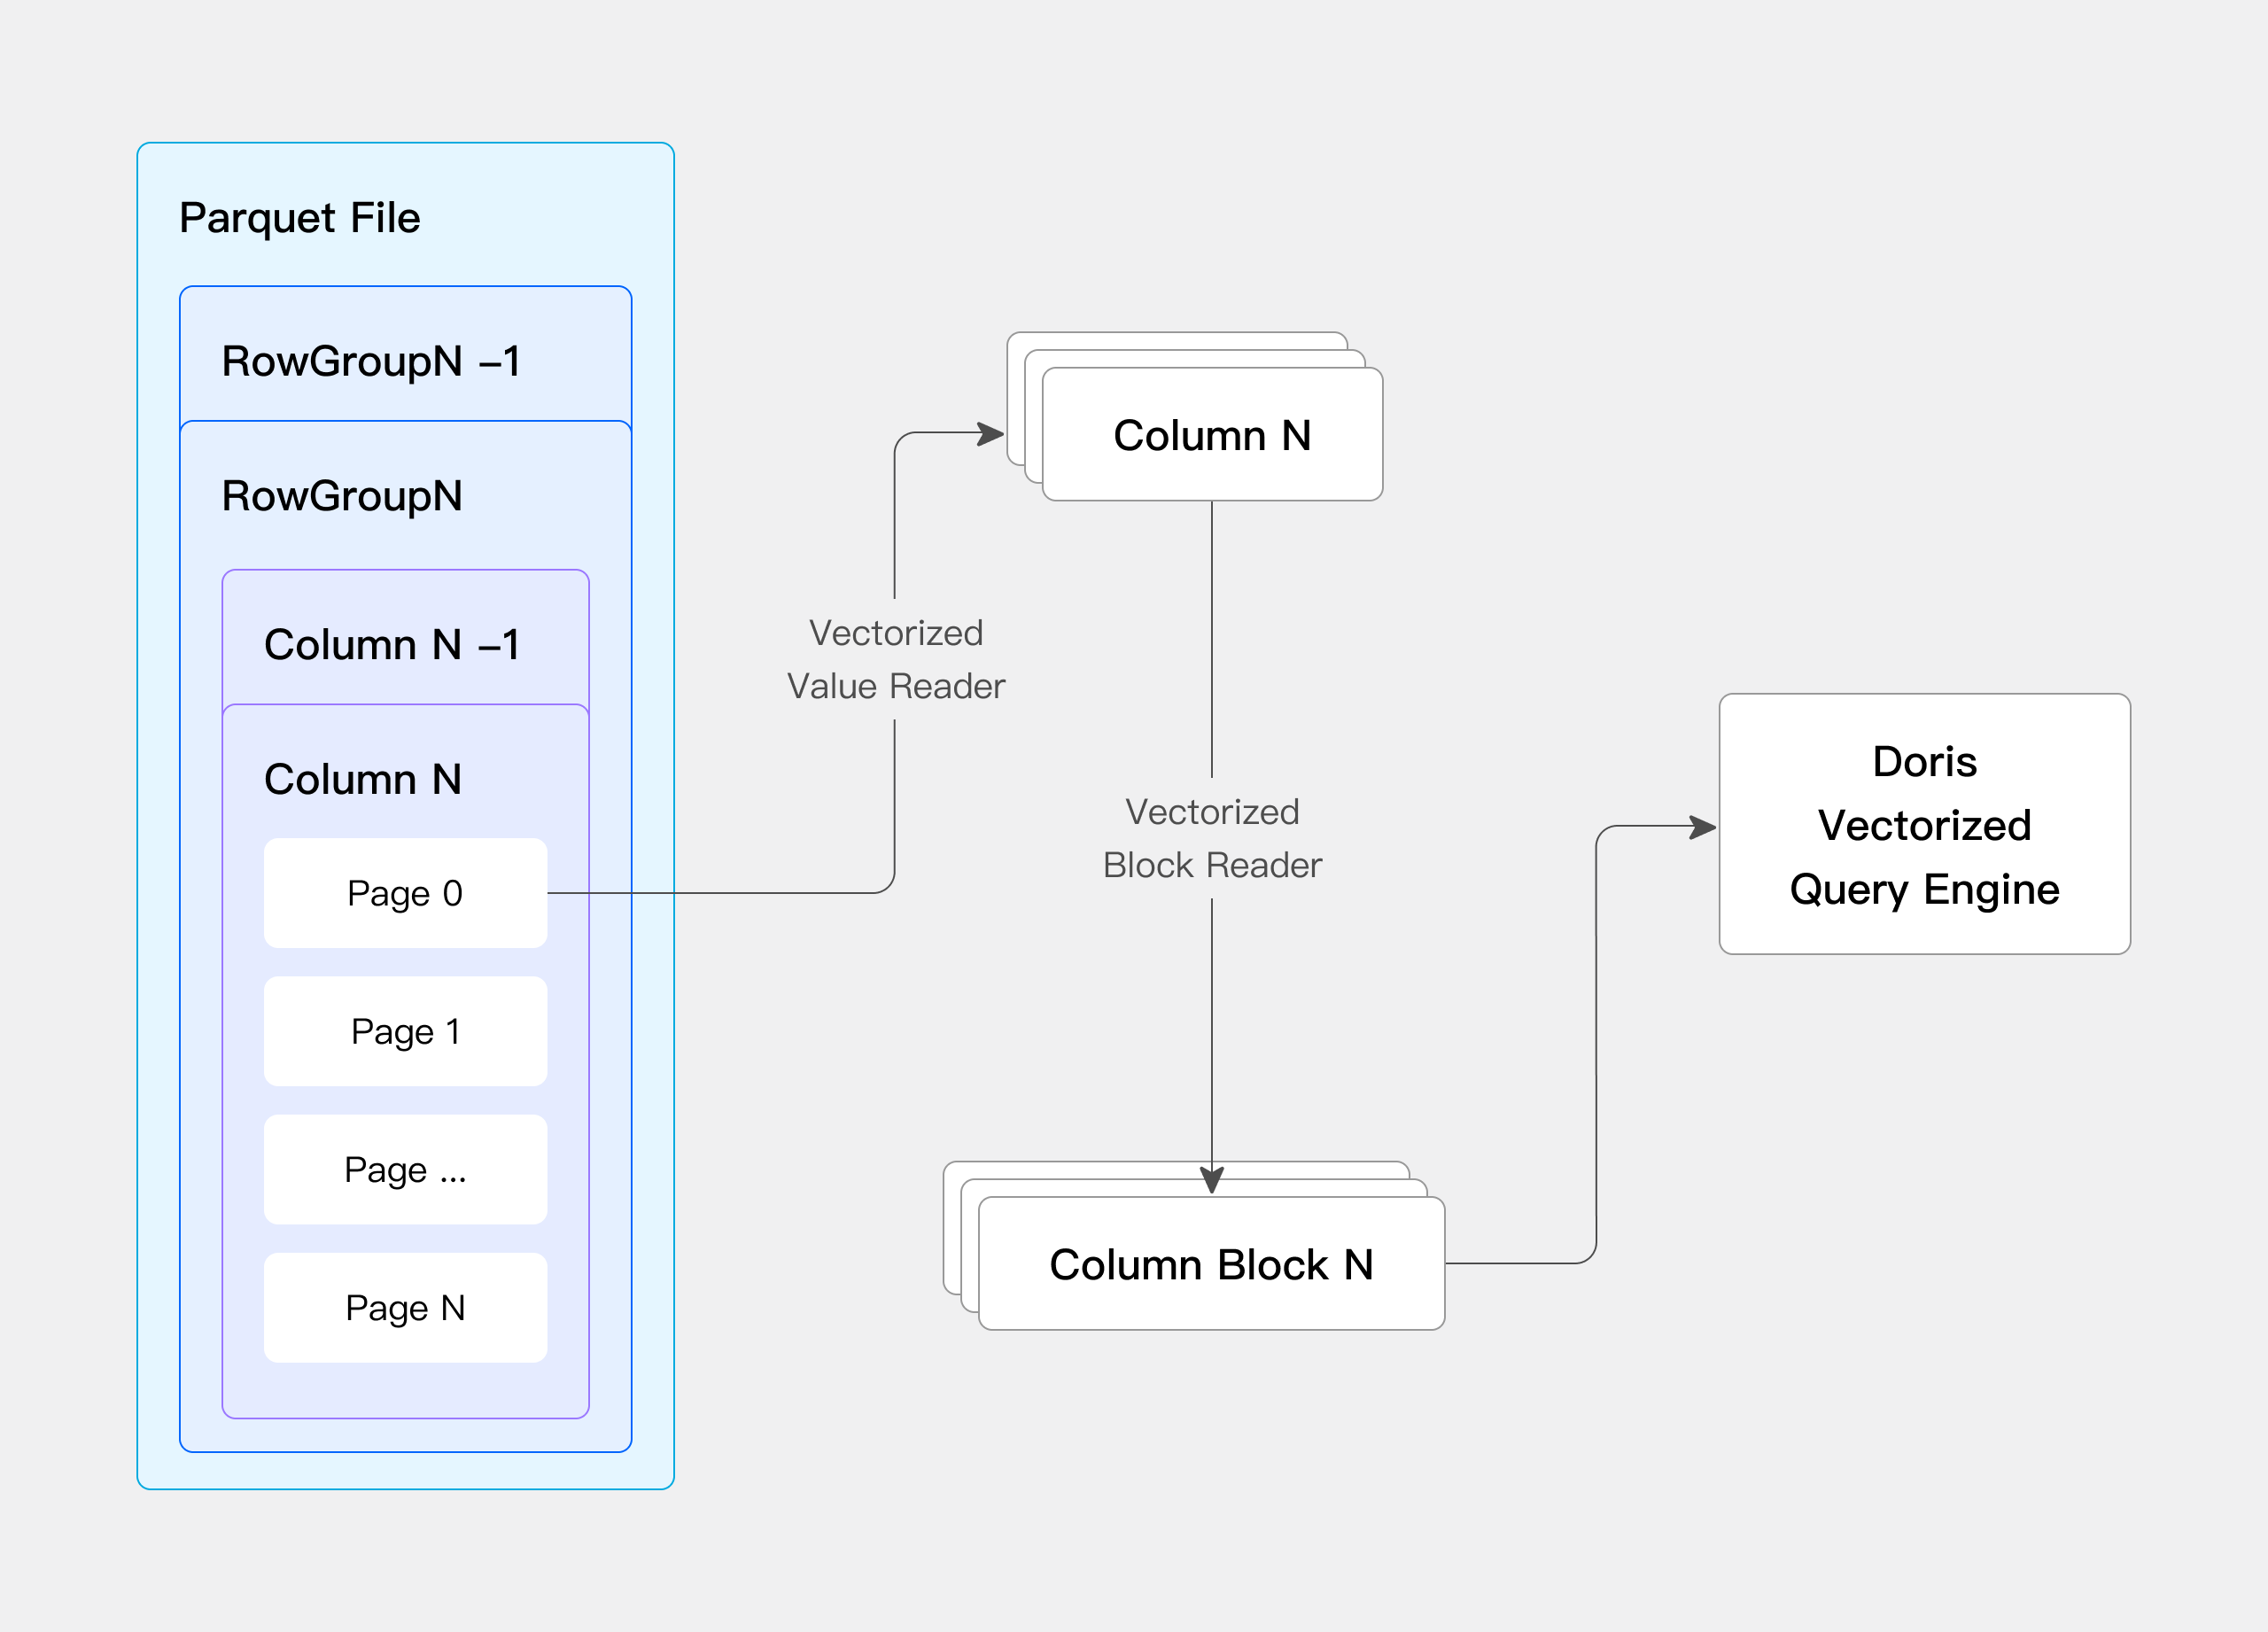
向量化读取数据:同时在文件数据的读取过程中我们引入向量化的方式读取数据,极大加速了数据读取效率。
3.4 Merge IO
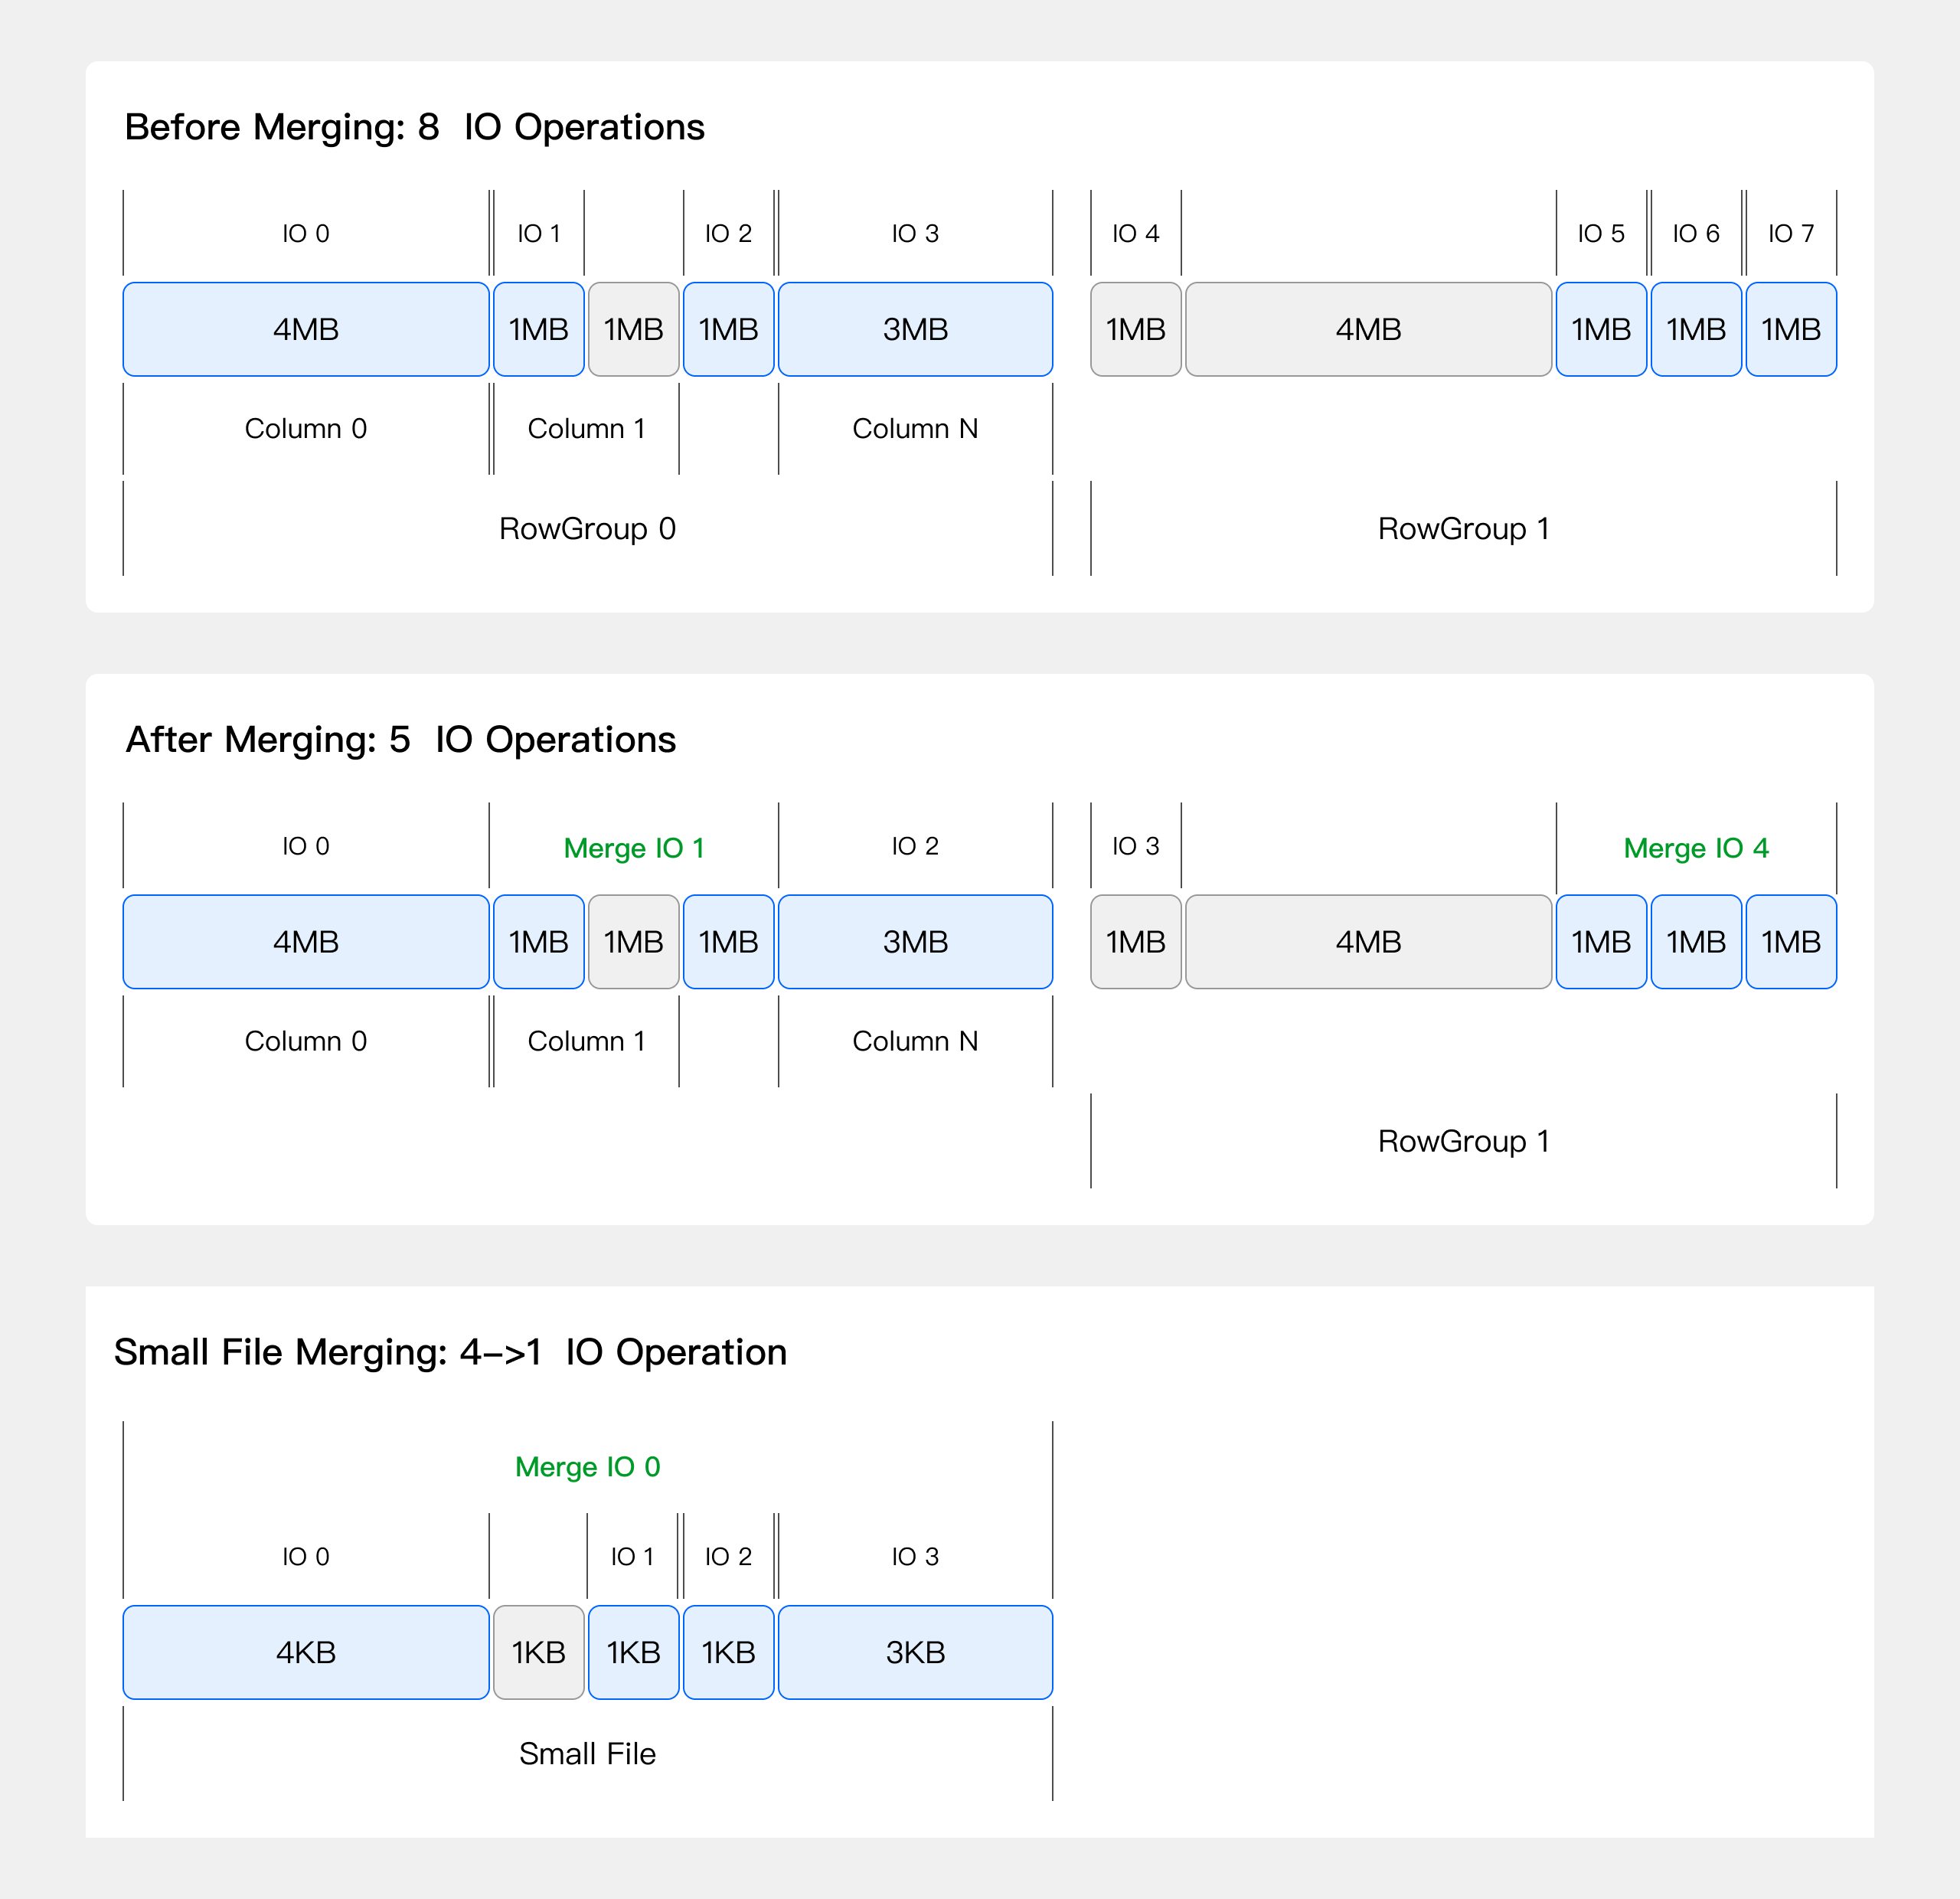
在网络中难免会出现大量小文件的网络 IO 请求取影响 IO 性能,在这种情况下我们采用 IO 合并去优化这种情况。
比如我们设置一个策略将小于 3MB 的 IO 请求合并( Merge IO )在一次请求中处理。那么之前可能是有 8 次的小的 IO 请求,我们可以把 8 次合并成 5 次 IO 请求去去读取数据。这样减少了网络 IO 请求的速度,提高了网络访问数据的效率。
Merge IO 的确定是它可能会读取一些不必要的数据,因为它把中间可能不必要读取的数据合并起来一块读过来了。但是从整体的吞吐上来讲其性能有很大的提高,在碎文件(比如: 1KB - 1MB )较多的场景优化效果很明显。同时我们通过控制 Merge IO 的大小来达到整体的平衡。
3.5 统计信息提高查询规划效果
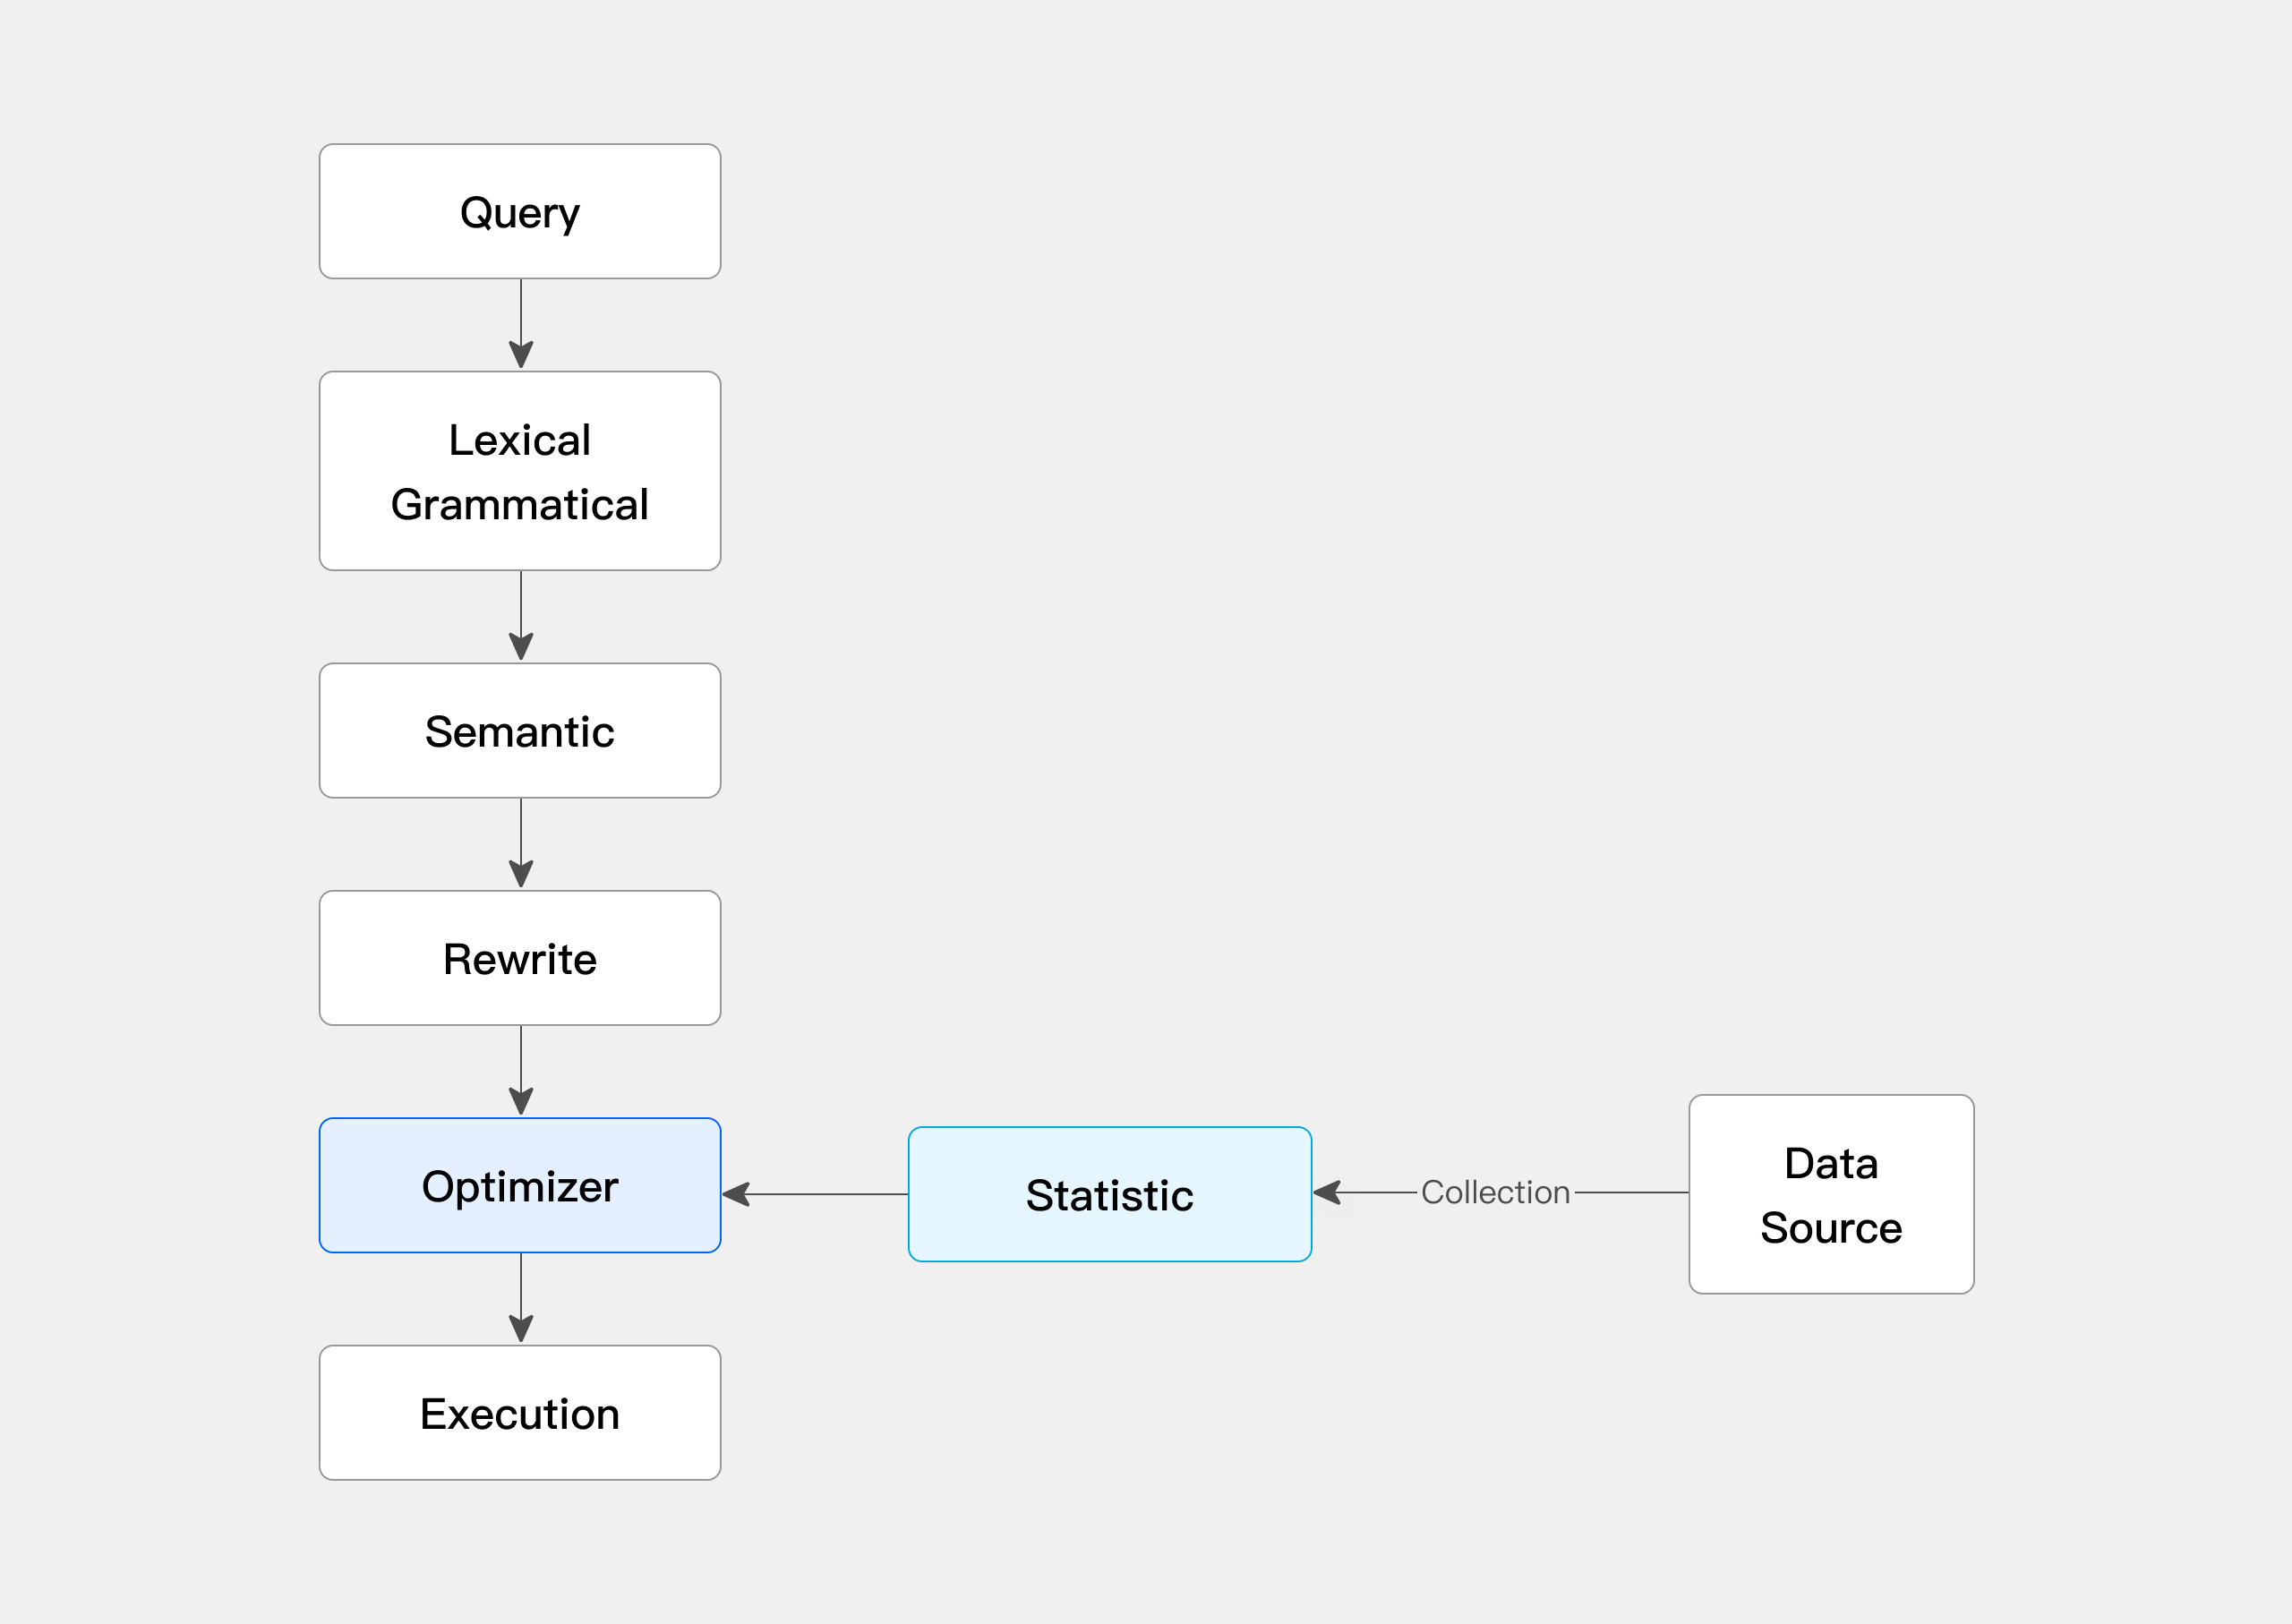
Doris 通过收集统计信息有助于优化器了解数据分布特性,在进行 CBO (基于成本优化)时优化器会利用这些统计信息来计算谓词的选择性,并估算每个执行计划的成本。从而选择更优的计划以大幅提升查询效率。在数据湖场景我们可以通过收集外表的统计信息来提升查询规划器的效果。
统计信息的收集方式包括手动收集和自动收集。
同时为了保证收集统计信息不会对 BE 产生压力,我们支持了采样收集统计信息。
在一些场景下用户历史数据可能很少查找,但是热数据会被经常访问,因此我们也提供了基于分区的统计信息收集在保障热数据高效的查询效率和统计信息收集对 BE 产生负载的中间取得平衡。
4 多源数据目录
多源数据目录( Multi-Catalog )功能,旨在能够更方便对接外部数据目录,以增强 Doris 的数据湖分析和联邦数据查询能力。
在之前的 Doris 版本中,用户数据只有两个层级: Database 和 Table 。当我们需要连接一个外部数据目录时,我们只能在 Database 或 Table 层级进行对接。比如通过 create external table 的方式创建一个外部数据目录中的表的映射,或通过 create external database 的方式映射一个外部数据目录中的 Database 。如果外部数据目录中的 Database 或 Table 非常多,则需要用户手动进行一一映射,使用体验不佳。
而新的 Multi-Catalog 功能在原有的元数据层级上,新增一层 Catalog ,构成 Catalog -> Database -> Table 的三层元数据层级。
该功能将作为之前外表连接方式( External Table )的补充和增强,帮助用户进行快速的多数据目录联邦查询。
4.1 基础概念
-
Internal CatalogDoris原有的Database和Table都将归属于Internal Catalog。Internal Catalog是内置的默认Catalog,用户不可修改或删除。 -
External Catalog可以通过
CREATE CATALOG命令创建一个External Catalog。创建后,可以通过SHOW CATALOGS命令查看已创建的Catalog。 -
切换
Catalog用户登录
Doris后,默认进入Internal Catalog,因此默认的使用和之前版本并无差别,可以直接使用SHOW DATABASES,USE DB等命令查看和切换数据库。用户可以通过
SWITCH命令切换Catalog。如:Text Only 1 2
SWITCH internal; SWITCH hive_catalog;切换后,可以直接通过
SHOW DATABASES,USE DB等命令查看和切换对应Catalog中的Database。Doris会自动通过Catalog中的Database和Table。用户可以像使用Internal Catalog一样,对External Catalog中的数据进行查看和访问。 -
删除
Catalog可以通过
DROP CATALOG命令删除一个External Catalog,Internal Catalog无法删除。该操作仅会删除Doris中该Catalog的映射信息,并不会修改或变更任何外部数据目录的内容。
4.2 连接示例
4.2.1 连接 Hive
这里我们通过连接一个 Hive 集群说明如何使用 Catalog 功能。
更多关于 Hive 的说明,请参阅: Hive Catalog
-
创建
CatalogSQL 1 2 3 4
CREATE CATALOG hive PROPERTIES ( 'type'='hms', 'hive.metastore.uris' = 'thrift://172.21.0.1:7004' );更多查看:
CREATE CATALOG语法帮助 -
查看
Catalog -
创建后,可以通过
SHOW CATALOGS命令查看catalog:SQL 1 2 3 4 5 6 7
mysql> SHOW CATALOGS; +-----------+-------------+----------+-----------+-------------------------+---------------------+------------------------+ | CatalogId | CatalogName | Type | IsCurrent | CreateTime | LastUpdateTime | Comment | +-----------+-------------+----------+-----------+-------------------------+---------------------+------------------------+ | 10024 | hive | hms | yes | 2023-12-25 16:11:41.687 | 2023-12-25 20:43:18 | NULL | | 0 | internal | internal | | UNRECORDED | NULL | Doris internal catalog | +-----------+-------------+----------+-----------+-------------------------+---------------------+------------------------+-
SHOW CATALOGS语法帮助 -
可以通过
SHOW CREATE CATALOG查看创建Catalog的语句。 -
可以通过
ALTER CATALOG修改Catalog的属性。
-
-
切换
Catalog通过
SWITCH命令切换到hive catalog,并查看其中的数据库:SQL 1 2 3 4 5 6 7 8 9 10 11 12 13 14
mysql> SWITCH hive; Query OK, 0 rows affected (0.00 sec) mysql> SHOW DATABASES; +-----------+ | Database | +-----------+ | default | | random | | ssb100 | | tpch1 | | tpch100 | | tpch1_orc | +-----------+查看更多:
SWITCH语法帮助 -
使用
Catalog切换到
Catalog后,则可以正常使用内部数据源的功能。如切换到
tpch100数据库,并查看其中的表:SQL 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16
mysql> USE tpch100; Database changed mysql> SHOW TABLES; +-------------------+ | Tables_in_tpch100 | +-------------------+ | customer | | lineitem | | nation | | orders | | part | | partsupp | | region | | supplier | +-------------------+查看
lineitem表的schema:SQL 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21
mysql> DESC lineitem; +-----------------+---------------+------+------+---------+-------+ | Field | Type | Null | Key | Default | Extra | +-----------------+---------------+------+------+---------+-------+ | l_shipdate | DATE | Yes | true | NULL | | | l_orderkey | BIGINT | Yes | true | NULL | | | l_linenumber | INT | Yes | true | NULL | | | l_partkey | INT | Yes | true | NULL | | | l_suppkey | INT | Yes | true | NULL | | | l_quantity | DECIMAL(15,2) | Yes | true | NULL | | | l_extendedprice | DECIMAL(15,2) | Yes | true | NULL | | | l_discount | DECIMAL(15,2) | Yes | true | NULL | | | l_tax | DECIMAL(15,2) | Yes | true | NULL | | | l_returnflag | TEXT | Yes | true | NULL | | | l_linestatus | TEXT | Yes | true | NULL | | | l_commitdate | DATE | Yes | true | NULL | | | l_receiptdate | DATE | Yes | true | NULL | | | l_shipinstruct | TEXT | Yes | true | NULL | | | l_shipmode | TEXT | Yes | true | NULL | | | l_comment | TEXT | Yes | true | NULL | | +-----------------+---------------+------+------+---------+-------+查询示例:
SQL 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
mysql> SELECT l_shipdate, l_orderkey, l_partkey FROM lineitem limit 10; +------------+------------+-----------+ | l_shipdate | l_orderkey | l_partkey | +------------+------------+-----------+ | 1998-01-21 | 66374304 | 270146 | | 1997-11-17 | 66374304 | 340557 | | 1997-06-17 | 66374400 | 6839498 | | 1997-08-21 | 66374400 | 11436870 | | 1997-08-07 | 66374400 | 19473325 | | 1997-06-16 | 66374400 | 8157699 | | 1998-09-21 | 66374496 | 19892278 | | 1998-08-07 | 66374496 | 9509408 | | 1998-10-27 | 66374496 | 4608731 | | 1998-07-14 | 66374592 | 13555929 | +------------+------------+-----------+也可以和其他数据目录中的表进行关联查询:
SQL 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
mysql> SELECT l.l_shipdate FROM hive.tpch100.lineitem l WHERE l.l_partkey IN (SELECT p_partkey FROM internal.db1.part) LIMIT 10; +------------+ | l_shipdate | +------------+ | 1993-02-16 | | 1995-06-26 | | 1995-08-19 | | 1992-07-23 | | 1998-05-23 | | 1997-07-12 | | 1994-03-06 | | 1996-02-07 | | 1997-06-01 | | 1996-08-23 | +------------+-
这里我们通过
catalog.database.table这种全限定的方式标识一张表,如:internal.db1.part。 -
其中
catalog和database可以省略,缺省使用当前SWITCH和USE后切换的Catalog和Database。 -
可以通过
INSERT INTO命令,将Hive Catalog中的表数据,插入到Interal Catalog中的内部表,从而达到导入外部数据目录数据的效果:
SQL 1 2 3 4 5 6 7 8 9
mysql> SWITCH internal; Query OK, 0 rows affected (0.00 sec) mysql> USE db1; Database changed mysql> INSERT INTO part SELECT * FROM hive.tpch100.part limit 1000; Query OK, 1000 rows affected (0.28 sec) {'label':'insert_212f67420c6444d5_9bfc184bf2e7edb8', 'status':'VISIBLE', 'txnId':'4'} -
4.3 列类型映射
用户创建 Catalog 后, Doris 会自动同步数据目录的数据库和表,针对不同的数据目录和数据表格式, Doris 会进行以下列映射关系。
对于当前无法映射到 Doris 列类型的外表类型,如 UNION , INTERVAL 等。 Doris 会将列类型映射为 UNSUPPORTED 类型。对于 UNSUPPORTED 类型的查询,示例如下:
假设同步后的表 schema 为:
| SQL | |
|---|---|
1 2 3 4 5 6 7 8 | |
不同的数据源的列映射规则,请参阅不同数据源的文档。
4.4 权限管理
使用 Doris 对 External Catalog 中库表进行访问时,默认情况下,依赖 Doris 自身的权限访问管理功能。
Doris 的权限管理功能提供了对 Catalog 层级的扩展,具体可参阅认证和鉴权文档。
用户也可以通过 access_controller.class 属性指定自定义的鉴权类。如通过指定:
| Bash | |
|---|---|
1 | |
则可以使用 Apache Ranger 对 Hive Catalog 进行鉴权管理。详细信息请参阅: Hive Catalog
4.5 指定需要同步的数据库
通过在 Catalog 配置中设置 include_database_list 和 exclude_database_list 可以指定需要同步的数据库。
include_database_list :支持只同步指定的多个 database ,以 , 分隔。默认同步所有 database 。 db 名称是大小写敏感的。
exclude_database_list :支持指定不需要同步的多个 database ,以 , 分割。默认不做任何过滤,同步所有 database 。 db 名称是大小写敏感的。
Tip
当 include_database_list 和 exclude_database_list 有重合的 database 配置时, exclude_database_list 会优先生效。
连接 JDBC 时,上述 2 个配置需要和配置 only_specified_database 搭配使用,详见 JDBC